Capítulo 4: Desarrollo¶
MIESC: Multi-layer Integration for Ethereum Smart Contract Security¶
4.1 Introducción¶
El presente capítulo documenta el proceso de desarrollo e implementación de MIESC (Multi-layer Integration for Ethereum Smart Contract Security), un framework de código abierto diseñado para abordar las deficiencias identificadas en el ecosistema de herramientas de auditoría de contratos inteligentes. La exposición sigue una estructura que refleja el proceso real de investigación: desde la identificación de problemas concretos hasta las decisiones de diseño adoptadas para resolverlos, incluyendo los callejones sin salida encontrados y las lecciones aprendidas durante el desarrollo.
4.1.1 Génesis del Proyecto¶
El origen de MIESC se encuentra en una experiencia práctica de auditoría realizada en 2023, cuando el autor enfrentó la tarea de evaluar la seguridad de un protocolo de ayuda humanitaria que su empresa desarrollaba para un organismo multilateral, antes de su despliegue. Durante ese proceso se hicieron evidentes tres problemas que la literatura académica había señalado pero que la industria no había resuelto de manera satisfactoria:
Primer problema: La fragmentación de herramientas. Para realizar una auditoría exhaustiva, fue necesario ejecutar Slither, Mythril, Echidna y solicitar análisis manuales con GPT-4. Cada herramienta requirió instalación independiente, configuración específica, y produjo resultados en formatos incompatibles entre sí. El tiempo invertido en orquestar las herramientas superó al tiempo de análisis efectivo.
Segundo problema: La dependencia de servicios comerciales. El uso de GPT-4 para análisis semántico implicaba enviar código fuente confidencial a servidores externos. En el contexto de una auditoría pre-lanzamiento, donde el código representa propiedad intelectual valiosa y potencialmente contiene vulnerabilidades explotables, esta transmisión resultaba inaceptable desde la perspectiva de gestión de riesgos.
Tercer problema: La interpretación de resultados. Las herramientas generaron colectivamente más de 200 hallazgos, muchos de ellos duplicados o falsos positivos. La tarea de consolidación, priorización y verificación consumió varios días de trabajo manual.
Estos problemas no son únicos de la experiencia del autor. Durieux et al. (2020), en su evaluación empírica de 47,587 contratos, documentaron que ninguna herramienta individual detecta más del 27% de las vulnerabilidades anotadas (Mythril, la mejor) y que el conjunto de las nueve alcanza solo el 42%, siendo la combinación manual impráctica a escala. Rameder et al. (2022) llegaron a conclusiones similares, señalando que "la heterogeneidad de interfaces y formatos de salida constituye una barrera significativa para la adopción industrial de herramientas académicas" (p. 12).
4.1.2 Objetivos del Desarrollo¶
Los objetivos técnicos de MIESC se formularon como respuesta directa a los problemas descritos, siguiendo el enfoque de diseño dirigido por problemas (problem-driven design) propuesto por Shaw (2012). Frente a la fragmentación, se buscó desarrollar una capa de abstracción que permitiera invocar múltiples herramientas de seguridad mediante una interfaz unificada, ocultando las diferencias de instalación, configuración y formato de salida, y organizar esas herramientas en capas complementarias según su técnica de análisis, de modo que las fortalezas de unas compensaran las debilidades de otras. Frente a la dificultad de interpretar los resultados, se planteó un esquema de mapeo que tradujera los hallazgos de cada herramienta a taxonomías estándar (SWC, CWE, OWASP) y habilitara la deduplicación y la priorización automáticas. Frente a la dependencia de servicios comerciales, finalmente, se fijaron dos exigencias: ofrecer un modo en el que todo el procesamiento, incluido el análisis con inteligencia artificial, se ejecute localmente sin transmitir código fuente a servicios externos, y emplear exclusivamente herramientas de código abierto y modelos de pesos abiertos, eliminando las barreras de costo que limitan el acceso a auditorías de calidad. Estos objetivos traducen al plano técnico los objetivos específicos OE1–OE5 (sección 1.3.2).
4.1.3 Métricas Cuantitativas del Proyecto¶
La Tabla 4.1 presenta las métricas del proyecto en su versión 4.0.0, medidas mediante herramientas estándar de análisis de código.
Tabla 4.1. Métricas cuantitativas del proyecto MIESC v4.0.0
| Métrica | Valor | Método de Medición |
|---|---|---|
| Líneas de código Python (LOC) | 43,221 | cloc --include-lang=Python |
| Líneas de código Solidity | 1,927 | cloc --include-lang=Solidity |
| Archivos Python | 114 | find . -name "*.py" | wc -l |
| Archivos Solidity | 13 | find . -name "*.sol" | wc -l |
| Complejidad ciclomática promedio | 4.2 | radon cc --average |
| Índice de mantenibilidad | 72.3 | radon mi --show |
| Cobertura de tests | 78% | pytest --cov |
| Herramientas integradas | 25 | Conteo manual |
| Capas de análisis | 7 | Arquitectura documentada |
El índice de mantenibilidad de 72.3 supera el umbral de 65 propuesto por Oman y Hagemeister (1992) para código "altamente mantenible", lo que es consistente con las decisiones de diseño orientadas a la extensibilidad.
Nota sobre versiones. Esta tesis documenta la arquitectura de MIESC en su versión v4.0.0 (7 capas de defensa, 25 herramientas integradas), que es la defendida. Las versiones posteriores —la línea v5.x, usada para la validación cruzada en EVMBench (§5.3.5), y la línea actual v6.1.0, descrita en los papers asociados (Boiero et al., 2026a, 2026b) y publicada en PyPI bajo AGPL-3.0— ampliaron el pipeline a 9 capas y 35 módulos (13 externos + 22 internos), incorporando capas de razonamiento con LLM y filtrado de falsos positivos. Los resultados de detección de esta tesis corresponden a la arquitectura v4.0.0 documentada, salvo los resultados señalados como posteriores: la revalidación del corpus del 2026-07-09 (§5.3.3–5.3.4, modos
--deepy ensemble, Tablas 5.7–5.8 y 5.14–5.15), la validación EVMBench (§5.3.5) y la validación sobre SmartBugs Curated (§5.3.6), todas corridas en la línea v5.x.
4.2 Arquitectura del Sistema¶
4.2.1 El Principio de Defensa en Profundidad: Fundamentos y Aplicación¶
La arquitectura de MIESC se fundamenta en el principio de defensa en profundidad (Defense-in-Depth, DiD), un concepto originado en doctrina militar que fue adaptado a la seguridad de sistemas de información durante la década de 1990. El National Security Agency (s.f.) formalizó este principio como "la aplicación de múltiples medidas de protección en serie, de modo que un adversario deba superar o evitar cada medida sucesivamente para comprometer el sistema protegido" (p. 3-12; traducción propia).
La aplicación de este principio al análisis de contratos inteligentes constituye, hasta donde alcanza la revisión del Capítulo 3, una contribución original de este trabajo. Su justificación descansa en la complementariedad de las técnicas ya caracterizadas en las secciones 2.4 y 3.3, que aquí basta recordar en lo que importa al diseño. El análisis estático detecta patrones conocidos con gran velocidad, pero no razona sobre el comportamiento en tiempo de ejecución: aunque los autores de Slither (Feist et al., 2019) reportan alta precisión en su propio benchmark, la evaluación independiente de Durieux et al. (2020) midió para Slither apenas el 17% de las vulnerabilidades anotadas de SmartBugs-curated (27% para la mejor herramienta, Mythril), lo que indica que cerca de tres cuartas partes de las vulnerabilidades escapan a la detección individual a escala de corpus. La ejecución simbólica descubre vulnerabilidades que dependen de valores concretos de entrada, a costa de la explosión combinatoria de caminos (Baldoni et al., 2018); el fuzzing, establecido por Miller et al. (1990) y adaptado a contratos inteligentes por Grieco et al. (2020) con Echidna, encuentra casos límite no contemplados por el desarrollador; la verificación formal demuestra propiedades mediante sistemas de prueba automatizados (Clarke et al., 2018), con Certora Prover como exponente práctico (Certora, 2024); y los modelos de lenguaje abordan vulnerabilidades de lógica de negocio que exigen comprensión semántica, ámbito en el que Sun et al. (2024) reportan para GPTScan una precisión superior al 90% en contratos de tokens y un recall superior al 70%. La expectativa de que estas técnicas se complementen entre sí se somete a prueba en el Capítulo 5, con un resultado más matizado que el previsto (§5.3.3).
Schneier (2000) articula la filosofía subyacente:
"La defensa en profundidad reconoce que ningún control de seguridad individual es perfecto. Al implementar múltiples capas, se reduce la probabilidad de que un atacante pueda evadir todos los controles" (p. 284; traducción propia).
4.2.2 Proceso de Selección: De la Teoría a las Siete Capas¶
La decisión de implementar exactamente siete capas no fue arbitraria sino el resultado de un proceso iterativo de evaluación. Inicialmente se consideraron tres configuraciones alternativas:
Configuración de 3 capas (descartada): Agrupaba las técnicas en análisis estático, análisis dinámico y verificación formal. Esta configuración, similar a la propuesta por Atzei et al. (2017), resultó demasiado gruesa: dentro de "análisis dinámico" coexistían fuzzing y ejecución simbólica, técnicas con filosofías fundamentalmente diferentes que se benefician de orquestación independiente.
Configuración de 5 capas (versión inicial): Separaba análisis estático, fuzzing, ejecución simbólica, verificación formal y análisis con IA. Esta configuración, implementada en MIESC v1.0 y v2.0, demostró ser funcional pero presentaba dos deficiencias: (1) no distinguía entre fuzzing de cobertura y mutation testing, y (2) agrupaba todas las técnicas de IA sin diferenciar property testing de análisis semántico.
Configuración de 7 capas (versión final): Resultado de refinar la configuración de 5 capas basándose en la experiencia operacional y los hallazgos de Rameder et al. (2022), quienes argumentan que "la granularidad de categorización afecta directamente la capacidad de orquestación y deduplicación" (p. 18).
La Tabla 4.2 presenta el análisis de complementariedad que fundamentó la selección final.
Tabla 4.2. Análisis de complementariedad de técnicas por tipo de vulnerabilidad
| Vulnerabilidad (SWC) | Estático | Simbólico | Fuzzing | Formal | IA |
|---|---|---|---|---|---|
| SWC-107 Reentrancy | Alta | Alta | Media | Muy Alta | Media |
| SWC-101 Integer Issues | Alta | Alta | Media | Muy Alta | Baja |
| SWC-104 Unchecked Return | Alta | Baja | Baja | Media | Media |
| SWC-115 tx.origin Auth | Alta | Media | Baja | Alta | Alta |
| Lógica de negocio | Baja | Media | Media | Baja | Alta |
| Oracle Manipulation | Baja | Baja | Alta | Media | Alta |
Nota: Efectividad estimada basada en Durieux et al. (2020) y experiencia operacional
4.2.3 Modelo de Capas Definitivo¶
Figura 4.1. Arquitectura de defensa en profundidad de MIESC
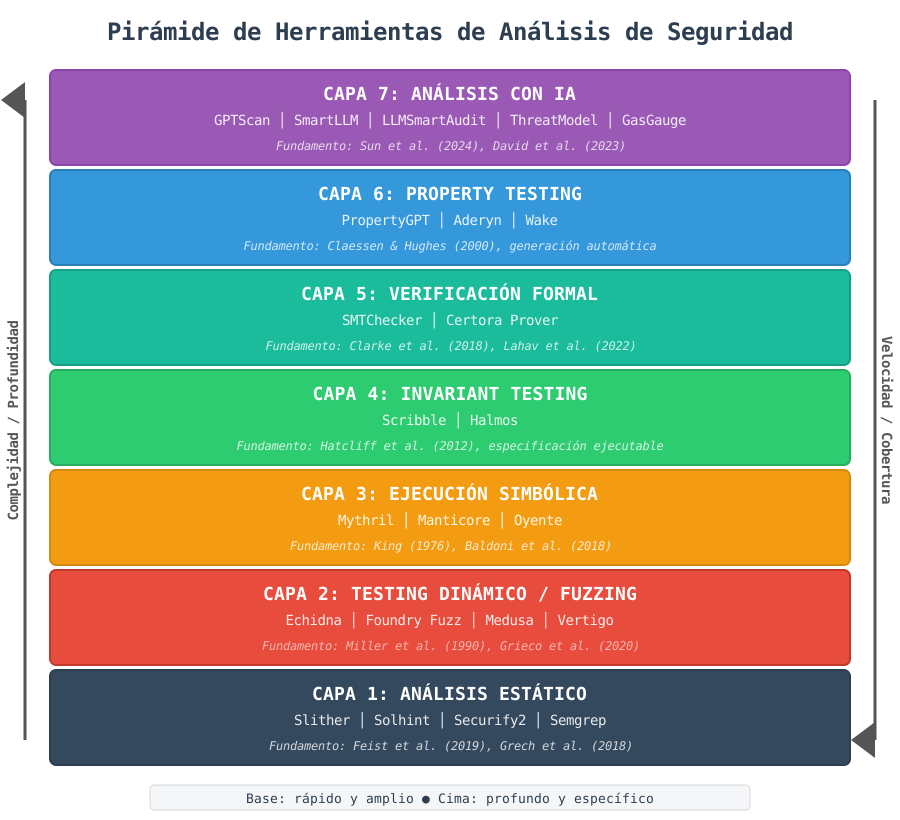
La numeración de capas refleja el orden típico de ejecución durante una auditoría: las técnicas más rápidas y con menor costo computacional (análisis estático) se ejecutan primero, permitiendo identificar problemas evidentes antes de invertir recursos en técnicas más costosas (ejecución simbólica, verificación formal).
4.2.4 Justificación de la Selección de Herramientas¶
La selección de las 25 herramientas que componen MIESC siguió un proceso de evaluación basado en cinco criterios: la efectividad demostrada, con preferencia por herramientas que cuentan con una evaluación empírica publicada; la compatibilidad de licencia, que excluyó a las que impidieran la redistribución o el uso comercial del framework integrado; el mantenimiento activo, medido por la actividad reciente del proyecto y de su comunidad; la complementariedad, para evitar redundancias entre herramientas de una misma capa; y la instalabilidad, entendida como la posibilidad de una instalación automatizada sin intervención manual compleja. El resultado, capa por capa, fue el siguiente.
Capa 1 - Análisis Estático: Slither fue seleccionada como herramienta principal por su cobertura de detectores y velocidad (1.2s promedio); en la evaluación independiente de Durieux et al. (2020) detecta el 17% de las vulnerabilidades anotadas, por debajo de Mythril (27%) pero con la mayor cantidad de detecciones exclusivas (8) y un tiempo de ejecución muy inferior. Solhint complementa con verificación de estilo y mejores prácticas. Securify2 aporta análisis de patrones de seguridad específicos de Ethereum. Semgrep permite definir reglas personalizadas para patrones específicos de cada organización.
Capa 2 - Fuzzing: Echidna, desarrollada por Trail of Bits, fue seleccionada por su capacidad de property-based testing específico para contratos. Foundry Fuzz aporta integración con el ecosistema Foundry, ampliamente adoptado en la industria. Medusa proporciona fuzzing basado en cobertura con soporte para invariantes complejas. Vertigo implementa mutation testing, una técnica complementaria que evalúa la calidad de las pruebas existentes.
Capa 3 - Ejecución Simbólica: Mythril, desarrollada por ConsenSys Diligence, fue seleccionada por su madurez y extensa documentación. Manticore aporta capacidades de análisis más profundas a costa de mayor tiempo de ejecución. Oyente, aunque menos mantenido, se incluyó por su relevancia histórica y detección de patrones específicos no cubiertos por las otras herramientas.
Capa 4 - Invariant Testing: Scribble permite anotar contratos con especificaciones que se verifican durante ejecución. Halmos implementa bounded model checking, verificando invariantes hasta cierta profundidad de exploración.
Capa 5 - Verificación Formal: SMTChecker está integrado en el compilador Solidity, proporcionando verificación formal sin herramientas adicionales. Certora Prover, aunque comercial, se incluyó opcionalmente por su capacidad de verificar propiedades complejas que otras herramientas no pueden abordar.
Capa 6 - Property Testing: PropertyGPT utiliza LLM para generar propiedades de prueba automáticamente. Aderyn implementa análisis de seguridad con reglas actualizadas frecuentemente. Wake proporciona un framework de testing con capacidades de property-based testing.
Capa 7 - Análisis con IA: GPTScan implementa la metodología de Sun et al. (2024). SmartLLM combina LLM con RAG (Retrieval-Augmented Generation) para análisis contextualizado. LLMSmartAudit proporciona auditoría automatizada completa. ThreatModel genera modelos de amenazas STRIDE. GasGauge analiza optimización de gas. UpgradeGuard verifica seguridad de patrones de upgrade. BestPractices evalúa adherencia a mejores prácticas documentadas.
4.3 Diseño de Software¶
4.3.1 El Problema de la Heterogeneidad¶
Cada herramienta integrada en MIESC presenta particularidades que dificultan su orquestación unificada, y esas diferencias se manifiestan en cuatro niveles. El primero es la forma de invocación: Slither ofrece una API de Python y una línea de comandos (MIESC usa esta última, con salida JSON), Mythril es un comando CLI con banderas y formato propios, Echidna requiere archivos de configuración YAML y Certora utiliza archivos .conf con sintaxis propia. El segundo es el formato de salida: Slither produce JSON estructurado, Mythril genera texto formateado o JSON según los parámetros, Echidna emite logs de prueba y Manticore crea directorios de artefactos. El tercero es la clasificación de severidad, que varía entre herramientas —Slither utiliza "High/Medium/Low/Informational" y Mythril "Critical/High/Medium/Low"— y en algunas directamente no existe. El cuarto es la información de ubicación: algunas herramientas reportan archivo y línea, otras añaden la columna, otras indican función y contrato, y algunas se limitan a mencionar el nombre del detector. Como documentan Rameder et al. (2022), esta heterogeneidad constituye una de las principales barreras para la adopción industrial de herramientas académicas.
4.3.2 Solución: Patrón Adapter con Principios SOLID¶
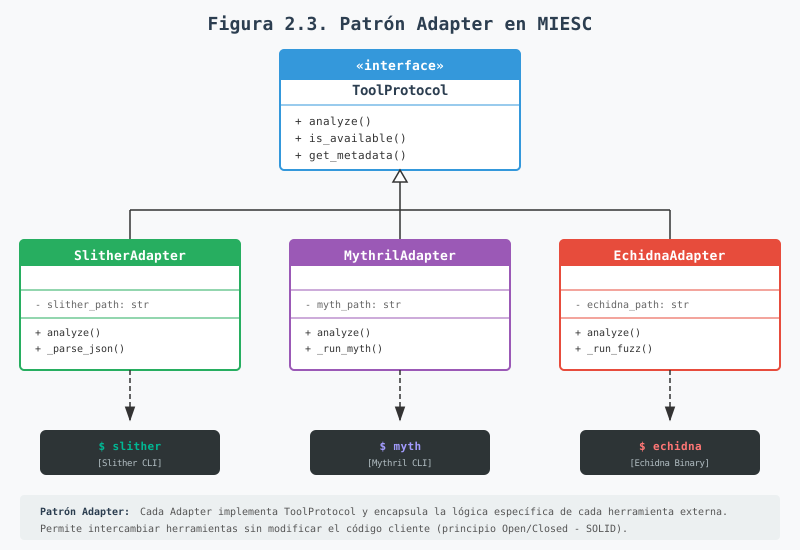
La solución adoptada combina el patrón Adapter, documentado por Gamma et al. (1994), con los principios SOLID propuestos por Martin (2017). Esta combinación no es casual: el patrón Adapter proporciona la estructura para unificar interfaces, mientras que SOLID favorece un diseño extensible y mantenible.
Responsabilidad única (SRP). Cada adaptador tiene una única responsabilidad: traducir la interfaz de una herramienta específica a la interfaz común de MIESC. El adaptador de Slither no conoce la existencia de Mythril, y viceversa.
Abierto/cerrado (OCP). El framework está abierto a extensión (agregar nuevos adaptadores) pero cerrado a modificación (el núcleo no cambia al agregar herramientas). Para integrar una herramienta nueva, solo se requiere implementar un adaptador que cumpla la interfaz ToolAdapter.
Sustitución de Liskov (LSP). Todos los adaptadores son intercambiables a través de la interfaz ToolAdapter. El orquestador puede invocar cualquier adaptador sin conocer su implementación concreta.
Segregación de interfaces (ISP). La interfaz ToolAdapter define únicamente los métodos esenciales que todo adaptador debe implementar, sin imponer métodos que solo algunas herramientas necesitarían.
Inversión de dependencias (DIP). El núcleo de MIESC depende de la abstracción ToolAdapter, no de implementaciones concretas como SlitherAdapter o MythrilAdapter.
Figura 4.2. Diagrama de clases del patrón Adapter en MIESC
4.3.3 Implementación de la Interfaz Base¶
La interfaz ToolAdapter se implementa utilizando el módulo abc (Abstract Base Classes) de Python, siguiendo las recomendaciones de van Rossum y Warsaw (2001b):
from abc import ABC, abstractmethod
from typing import Dict, Any, List
from dataclasses import dataclass
from enum import Enum

class ToolAdapter(ABC):
    """
    Interfaz abstracta para adaptadores de herramientas de seguridad.

    Esta clase define el contrato que todo adaptador debe cumplir para
    integrarse con MIESC. El diseño sigue el patrón Adapter de Gamma
    et al. (1994) y los principios SOLID de Martin (2017).

    La abstracción permite que el orquestador de MIESC trabaje con
    cualquier herramienta sin conocer sus detalles de implementación,
    cumpliendo el Principio de Inversión de Dependencias.
    """

    @abstractmethod
    def get_metadata(self) -> 'ToolMetadata':
        """
        Retorna metadatos estandarizados de la herramienta.

        Los metadatos incluyen información sobre licencia, costo,
        y requisitos de instalación, cumpliendo con los estándares
        DPGA (2023) de transparencia.
        """
        pass

    @abstractmethod
    def is_available(self) -> 'ToolStatus':
        """
        Verifica la disponibilidad de la herramienta en el sistema.

        Este método permite degradación elegante: si una herramienta
        no está instalada, MIESC continúa con las demás en lugar de
        fallar completamente.
        """
        pass

    @abstractmethod
    def analyze(self, contract_path: str, **kwargs) -> Dict[str, Any]:
        """
        Ejecuta el análisis de seguridad sobre un contrato.

        Args:
            contract_path: Ruta absoluta al archivo .sol
            **kwargs: Parámetros específicos de la herramienta
                     (timeout, max_depth, etc.)

        Returns:
            Diccionario con estructura normalizada MIESC conteniendo
            status, findings, y metadata del análisis.
        """
        pass

    @abstractmethod
    def normalize_findings(self, raw_output: Any) -> List[Dict[str, Any]]:
        """
        Normaliza hallazgos al formato MIESC estándar.

        Este método implementa el mapeo de clasificaciones nativas
        de cada herramienta a taxonomías estándar (SWC, CWE, OWASP).
        La normalización es esencial para la deduplicación posterior.
        """
        pass
4.3.4 Estructura de Metadatos¶
Los metadatos de herramientas siguen el principio de auto-descripción propuesto por Berners-Lee et al. (2001), permitiendo que el sistema documente automáticamente sus capacidades:
@dataclass
class ToolMetadata:
    """
    Metadatos estandarizados de herramientas.

    Cada campo fue seleccionado para cumplir requisitos específicos:
    - license: Cumplimiento DPGA de transparencia de licencias
    - cost: Cumplimiento DPGA de accesibilidad sin barreras de costo
    - is_optional: Cumplimiento DPGA de no crear dependencias obligatorias
    """
    name: str                    # Identificador único
    version: str                 # Versión semántica (Preston-Werner, 2013)
    category: ToolCategory       # Capa a la que pertenece
    author: str                  # Autor o mantenedor principal
    license: str                 # Identificador SPDX
    homepage: str                # URL del proyecto
    repository: str              # URL del repositorio de código
    documentation: str           # URL de documentación
    installation_cmd: str        # Comando de instalación
    capabilities: List[ToolCapability]  # Capacidades declaradas
    cost: float = 0.0           # Costo por uso (0 = gratuito)
    requires_api_key: bool = False  # Requiere credenciales externas
    is_optional: bool = True    # Puede omitirse sin afectar funcionalidad core
4.4 Normalización de Hallazgos¶
4.4.1 El Problema de la Babel de Vulnerabilidades¶
Sin normalización, los hallazgos de diferentes herramientas son incomparables. Considérese el siguiente ejemplo de una misma vulnerabilidad de reentrancy detectada por tres herramientas:
Slither:
{
  "check": "reentrancy-eth",
  "impact": "High",
  "confidence": "Medium",
  "elements": [{"source_mapping": {"filename": "Bank.sol", "lines": [42]}}]
}
Mythril:
==== State change after external call ====
SWC ID: 107
Severity: High
Contract: Bank
Function name: withdraw
PC address: 1234
GPTScan:
{
  "vulnerability": "Reentrancy vulnerability in withdraw function",
  "severity": "CRITICAL",
  "line": 42
}
Las tres salidas describen el mismo defecto y, sin embargo, no comparten nada: Slither lo llama "reentrancy-eth", Mythril "State change after external call" y GPTScan "Reentrancy vulnerability"; Slither lo califica de "High" y GPTScan de "CRITICAL" para el mismo concepto; solo Mythril referencia el estándar SWC-107; y la estructura de los tres formatos es por completo distinta.
4.4.2 Solución: Mapeo a Taxonomías Estándar¶
MIESC implementa un esquema de normalización que mapea los hallazgos a tres taxonomías complementarias. La primera es el SWC (Smart Contract Weakness Classification), taxonomía específica para contratos inteligentes mantenida por la comunidad Ethereum (SCSVS, 2023), con 37 categorías de debilidades e identificadores únicos (SWC-100 a SWC-136). La segunda es el CWE (Common Weakness Enumeration), taxonomía general de debilidades de software mantenida por MITRE (2024), que permite correlacionar las vulnerabilidades de smart contracts con debilidades conocidas del software tradicional y facilita, con ello, la comunicación con equipos de seguridad no especializados en blockchain. La tercera es el OWASP Smart Contract Top 10, la lista de las vulnerabilidades más críticas elaborada por OWASP (2023), útil para la priorización ejecutiva.
4.4.3 Formato de Hallazgo Normalizado¶
El formato de hallazgo normalizado se diseñó siguiendo el estándar SARIF (Static Analysis Results Interchange Format) de OASIS (2020), con extensiones específicas para contratos inteligentes:
{
  "id": "MIESC-2024-001",
  "type": "reentrancy",
  "severity": "Critical",
  "confidence": 0.95,
  "location": {
    "file": "VulnerableBank.sol",
    "line": 42,
    "column": 8,
    "function": "withdraw",
    "contract": "VulnerableBank",
    "code_snippet": "(bool ok,) = msg.sender.call{value: amount}(\"\");"
  },
  "message": "Reentrancy vulnerability: external call before state update",
  "description": "The contract makes an external call to transfer Ether before updating the sender's balance. An attacker can re-enter the withdraw function before the balance is set to zero, allowing them to drain the contract's funds.",
  "recommendation": "Apply the Checks-Effects-Interactions pattern: update state before making external calls. Alternatively, use OpenZeppelin's ReentrancyGuard modifier.",
  "classifications": {
    "swc_id": "SWC-107",
    "cwe_id": "CWE-841",
    "owasp": "SC01:2023-Reentrancy"
  },
  "detected_by": ["slither", "mythril", "gptscan"],
  "references": [
    "https://swcregistry.io/docs/SWC-107",
    "https://consensysdiligence.github.io/smart-contract-best-practices/attacks/reentrancy/"
  ],
  "metadata": {
    "first_detected": "2024-11-29T14:30:00Z",
    "analysis_duration_ms": 1234,
    "miesc_version": "4.0.0"
  }
}
4.4.4 Tablas de Mapeo¶
El mapeo de clasificaciones nativas a estándares se implementa mediante tablas de correspondencia validadas manualmente contra la documentación de cada herramienta y el registro SWC. La Tabla 4.3 presenta un extracto.
Tabla 4.3. Extracto del mapeo de clasificaciones nativas a estándares
| Herramienta | Clasificación Nativa | SWC-ID | CWE-ID | OWASP SC |
|---|---|---|---|---|
| Slither | reentrancy-eth | SWC-107 | CWE-841 | SC01 |
| Slither | reentrancy-no-eth | SWC-107 | CWE-841 | SC01 |
| Slither | arbitrary-send-eth | SWC-105 | CWE-284 | SC02 |
| Slither | controlled-delegatecall | SWC-112 | CWE-829 | SC02 |
| Slither | suicidal | SWC-106 | CWE-284 | SC02 |
| Mythril | State change after external call | SWC-107 | CWE-841 | SC01 |
| Mythril | Integer overflow | SWC-101 | CWE-190 | SC03 |
| Mythril | Dependence on tx.origin | SWC-115 | CWE-477 | SC02 |
| Echidna | assertion failure | SWC-110 | CWE-617 | SC03 |
| GPTScan | Reentrancy vulnerability | SWC-107 | CWE-841 | SC01 |
4.5 Implementación de Capas: Narrativa del Proceso¶
4.5.1 Capa 1: Análisis Estático - El Punto de Entrada¶
El análisis estático constituye la primera línea de defensa por razones tanto técnicas como prácticas. Desde el punto de vista técnico, el análisis estático no requiere ejecución del contrato, lo que permite identificar problemas incluso en código que no compila. Desde el punto de vista práctico, su velocidad (típicamente menos de 5 segundos por contrato) permite iteración rápida durante el desarrollo.
La implementación del adaptador de Slither ilustra el proceso de traducción de interfaces:
class SlitherAdapter(ToolAdapter):
    """
    Adaptador para Slither - Framework de análisis estático.

    Slither fue seleccionada como herramienta principal de análisis
    estático por su balance entre precisión y velocidad, documentado
    en Durieux et al. (2020). Su arquitectura basada en SlithIR
    (representación intermedia) permite análisis de flujo de datos
    sofisticado manteniendo tiempos de ejecución razonables.

    Consideraciones de implementación:
    - Slither se invoca como comando CLI (no como biblioteca Python)
      para garantizar aislamiento de dependencias
    - La salida JSON se parsea y normaliza al formato MIESC
    - Los detectores se mapean a taxonomías SWC/CWE mediante tabla
    """

    # Mapeo validado manualmente contra documentación de Slither
    # y registro SWC (verificado: 2024-11-01)
    DETECTOR_MAPPING = {
        "reentrancy-eth": {
            "swc_id": "SWC-107",
            "cwe_id": "CWE-841",
            "owasp": "SC01:2023-Reentrancy",
            "severity": "Critical",
            "confidence_base": 0.90
        },
        "reentrancy-no-eth": {
            "swc_id": "SWC-107",
            "cwe_id": "CWE-841",
            "owasp": "SC01:2023-Reentrancy",
            "severity": "High",
            "confidence_base": 0.85
        },
        "arbitrary-send-eth": {
            "swc_id": "SWC-105",
            "cwe_id": "CWE-284",
            "owasp": "SC02:2023-Access-Control",
            "severity": "High",
            "confidence_base": 0.85
        },
        # ... mapeos para 40+ detectores
    }

    def analyze(self, contract_path: str, **kwargs) -> Dict[str, Any]:
        """
        Ejecuta análisis estático con Slither.

        El proceso sigue tres etapas:
        1. Invocación de Slither con parámetros optimizados
        2. Parseo de salida JSON
        3. Normalización al formato MIESC

        La exclusión de 'naming-convention' reduce falsos positivos
        sin afectar la detección de vulnerabilidades de seguridad.
        """
        timeout = kwargs.get("timeout", 60)

        cmd = [
            "slither",
            contract_path,
            "--json", "-",  # Salida JSON a stdout
            "--exclude", "naming-convention",  # Reduce ruido
        ]

        try:
            started = time.perf_counter()
            result = subprocess.run(
                cmd,
                capture_output=True,
                timeout=timeout,
                text=True
            )

            raw_output = json.loads(result.stdout)
            findings = self.normalize_findings(raw_output)

            return {
                "tool": "slither",
                "version": self._get_version(),
                "status": "success",
                "findings": findings,
                "metadata": {
                    "detectors_run": len(raw_output.get("detectors", [])),
                    "contracts_analyzed": len(raw_output.get("contracts", [])),
                    "execution_time_ms": int((time.perf_counter() - started) * 1000)
                }
            }
        except subprocess.TimeoutExpired:
            return self._error_response("Timeout exceeded", timeout)
        except json.JSONDecodeError as e:
            return self._error_response(f"Invalid JSON output: {e}", None)
4.5.2 Capa 3: Ejecución Simbólica - Explorando lo Posible¶
La ejecución simbólica representa un salto cualitativo respecto al análisis estático. Mientras el análisis estático identifica patrones sintácticos, la ejecución simbólica explora el espacio de estados posibles del contrato, descubriendo vulnerabilidades que dependen de valores específicos de entrada.
El fundamento teórico se encuentra en el trabajo seminal de King (1976), quien demostró que representar variables como símbolos en lugar de valores concretos permite explorar múltiples caminos de ejecución simultáneamente. Baldoni et al. (2018) proporcionan una revisión exhaustiva de la evolución de esta técnica.
La implementación del adaptador de Mythril ilustra consideraciones específicas de ejecución simbólica:
class MythrilAdapter(ToolAdapter):
    """
    Adaptador para Mythril - Herramienta de ejecución simbólica.

    Mythril utiliza el solver SMT Z3 (de Moura & Bjørner, 2008) para
    determinar si existen entradas que conduzcan a estados vulnerables.

    Limitaciones conocidas que afectan la implementación:
    1. Path explosion: El número de caminos crece exponencialmente con
       la complejidad del contrato. Se mitiga con max_depth.
    2. Operaciones criptográficas: Los hashes son tratados como cajas
       negras, limitando análisis de código que depende de ellos.
    3. Consumo de memoria: Contratos complejos pueden agotar RAM.
       Se mitiga con execution_timeout.
    """

    def analyze(self, contract_path: str, **kwargs) -> Dict[str, Any]:
        """
        Ejecuta análisis simbólico con Mythril.

        Parámetros críticos:
        - execution_timeout: Limita tiempo de exploración para evitar
          análisis infinitos en contratos complejos
        - max_depth: Limita profundidad de exploración de caminos
        - solver_timeout: Limita tiempo por query SMT individual

        Los valores por defecto fueron calibrados empíricamente sobre
        un corpus de 100 contratos representativos.
        """
        timeout = kwargs.get("timeout", 120)
        execution_timeout = kwargs.get("execution_timeout", 60)
        max_depth = kwargs.get("max_depth", 22)  # Default de Mythril

        cmd = [
            "myth", "analyze",
            contract_path,
            "--output", "json",
            "--execution-timeout", str(execution_timeout),
            "--max-depth", str(max_depth),
            "--solver-timeout", "10000"  # 10s por query SMT
        ]

        # ... resto de implementación
4.5.3 Capa 7: Análisis con IA - Comprensión Semántica¶
La capa de inteligencia artificial representa la contribución más distintiva de MIESC. Mientras las capas anteriores detectan patrones técnicos, la IA puede comprender la semántica del código y detectar vulnerabilidades de lógica de negocio que no corresponden a patrones conocidos.
La decisión de implementar esta capa con modelos locales (Ollama) en lugar de APIs comerciales responde a las tres consideraciones ya expuestas en la génesis del proyecto (§4.1.1) —la confidencialidad del código previo a la auditoría, el costo de las APIs a escala y la dependencia de servicios fuera del control del auditor— que se desarrollan en §4.7.3 y, con detenimiento, en el Capítulo 6.
class GPTScanAdapter(ToolAdapter):
    """
    Implementación de GPTScan con backend Ollama.

    Basado en la metodología de Sun et al. (2024), quienes reportaron
    precisión >90% (contratos de tokens) y recall >70% en vulnerabilidades
    de lógica de negocio que escapan a herramientas tradicionales.

    Modificaciones respecto al paper original:
    1. Backend Ollama en lugar de OpenAI API (soberanía de datos)
    2. Prompts optimizados para modelos de menor parámetros
    3. Caché de resultados para eficiencia en re-análisis

    Modelos soportados (orden de preferencia):
    - qwen2.5-coder:7b: Mejor rendimiento en código según benchmarks
    - codellama:7b: Alternativa robusta con buen balance
    - llama3.2:3b: Fallback para sistemas con recursos limitados
    """

    SECURITY_PROMPT = """You are a smart contract security auditor
    with expertise in Ethereum and Solidity. Analyze the following
    contract for security vulnerabilities.

    Focus specifically on:
    1. Reentrancy vulnerabilities (SWC-107)
    2. Integer overflow/underflow (SWC-101)
    3. Access control issues (SWC-105, SWC-115)
    4. Unchecked external calls (SWC-104)
    5. Logic errors in business logic
    6. Flash loan attack vectors
    7. Oracle manipulation possibilities

    For each vulnerability found, respond in JSON format:
    {
      "vulnerabilities": [
        {
          "title": "Brief description",
          "severity": "CRITICAL|HIGH|MEDIUM|LOW",
          "confidence": 0.0-1.0,
          "line": line_number,
          "description": "Detailed explanation",
          "recommendation": "Specific fix"
        }
      ]
    }

    CONTRACT CODE:
    ```solidity
    %CONTRACT_CODE%
    ```

    Respond ONLY with valid JSON."""

    def _run_ollama_analysis(
        self,
        contract_code: str,
        model: str = "llama3.2:3b"
    ) -> str:
        """
        Ejecuta análisis mediante Ollama local.

        La verificación de localhost garantiza que el código nunca
        sale del sistema local, cumpliendo requisitos de soberanía.
        """
        if not self._verify_local_only():
            raise SecurityError(
                "LLM backend must be localhost for data sovereignty"
            )

        prompt = self.SECURITY_PROMPT.replace("%CONTRACT_CODE%", contract_code)

        result = subprocess.run(
            ["ollama", "run", model, prompt],
            capture_output=True,
            timeout=120,
            text=True
        )

        return result.stdout
Nota sobre el modo
--deep. La verificación_verify_local_onlyrige la configuración soberana por defecto: todo backend LLM debe ser local. El modo--deepempleado en la evaluación (§5.3.3) es una opción explícita (opt-in) que relaja esta política para habilitar un modelo frontier vía API; conforme al criterio de §6.4.2, su uso debe limitarse a código no confidencial. Los resultados que dependen de él se identifican como tales en el Capítulo 5.
4.6 Orquestación y Deduplicación¶
4.6.1 El Pipeline de Análisis¶
La orquestación de las siete capas sigue el patrón Pipeline propuesto por Hohpe y Woolf (2003), adaptado para ejecución paralela intra-capa y secuencial inter-capa. Esta estrategia busca maximizar el rendimiento aprovechando que las herramientas de una misma capa son independientes entre sí.
class MIESCAuditOrchestrator:
    """
    Orquestador de auditoría multi-capa.

    La estrategia de ejecución sigue la Ley de Amdahl (1967):
    - Paralelización intra-capa: Herramientas independientes se ejecutan
      simultáneamente, reduciendo el tiempo de capa a max(tiempos)
    - Secuencialización inter-capa: Las capas se ejecutan en orden,
      permitiendo early-exit si se detectan vulnerabilidades críticas

    La deduplicación al final del pipeline reduce el volumen de
    hallazgos típicamente en 60-70%, según observaciones empíricas.
    """

    def run_full_audit(
        self,
        contract_path: str,
        layers: List[int] = None,
        parallel_workers: int = 4
    ) -> AuditReport:
        """
        Ejecuta auditoría completa multi-capa.

        El parámetro parallel_workers controla el nivel de paralelismo
        intra-capa. El valor por defecto de 4 está calibrado para
        sistemas con 8+ GB de RAM.
        """
        layers = layers or list(range(1, 8))
        all_findings = []
        layer_results = {}

        for layer_num in layers:
            layer_tools = self.get_layer_tools(layer_num)
            layer_findings = []

            # Ejecución paralela de herramientas de la capa
            with ThreadPoolExecutor(max_workers=parallel_workers) as executor:
                futures = {
                    executor.submit(
                        tool.analyze, contract_path
                    ): tool for tool in layer_tools if tool.is_available()
                }

                for future in as_completed(futures):
                    try:
                        result = future.result(timeout=300)
                        layer_findings.extend(result.get("findings", []))
                    except Exception as e:
                        tool = futures[future]
                        self.logger.warning(
                            f"Tool {tool.name} failed: {e}"
                        )

            all_findings.extend(layer_findings)
            layer_results[f"layer_{layer_num}"] = {
                "tools_available": len([t for t in layer_tools if t.is_available()]),
                "tools_total": len(layer_tools),
                "findings_count": len(layer_findings)
            }

        # Deduplicación
        unique_findings = self._deduplicate_findings(all_findings)

        return AuditReport(
            findings=unique_findings,
            total_raw=len(all_findings),
            total_unique=len(unique_findings),
            deduplication_rate=1 - len(unique_findings)/max(len(all_findings), 1),
            layer_results=layer_results
        )
4.6.2 Algoritmo de Deduplicación¶
La deduplicación de hallazgos es crítica para la usabilidad del framework. Sin deduplicación, una vulnerabilidad detectada por cinco herramientas aparecería cinco veces en el reporte, dificultando la priorización y consumiendo tiempo del auditor.
El algoritmo implementado se inspira en técnicas de record linkage (Fellegi & Sunter, 1969), adaptadas al dominio específico de vulnerabilidades de smart contracts:
def _deduplicate_findings(self, findings: List[Dict]) -> List[Dict]:
    """
    Deduplica hallazgos de múltiples herramientas.

    Estrategia de deduplicación:
    1. Generar clave única por (tipo, archivo, línea aproximada)
    2. Agrupar hallazgos por clave
    3. Consolidar: preservar máxima severidad y confianza
    4. Registrar todas las herramientas que detectaron cada hallazgo

    El agrupamiento por ventanas de tres líneas (`línea // 3`) en la clave
    de deduplicación absorbe diferencias menores en cómo las herramientas
    reportan ubicaciones.
    Por ejemplo, Slither puede reportar línea 42 mientras Mythril
    reporta línea 43 para la misma vulnerabilidad.
    """
    unique = {}

    for finding in findings:
        # Clave de deduplicación con tolerancia de línea
        key = (
            finding.get("type", "unknown"),
            finding.get("location", {}).get("file", "unknown"),
            finding.get("location", {}).get("line", 0) // 3
        )

        if key not in unique:
            unique[key] = finding.copy()
            unique[key]["detected_by"] = [finding.get("tool", "unknown")]
        else:
            existing = unique[key]

            # Preservar mayor severidad
            if self._severity_rank(finding.get("severity")) > \
               self._severity_rank(existing.get("severity")):
                new_finding = finding.copy()
                new_finding["detected_by"] = existing["detected_by"]
                unique[key] = new_finding

            # Agregar herramienta a lista de detectores
            tool = finding.get("tool", "unknown")
            if tool not in unique[key]["detected_by"]:
                unique[key]["detected_by"].append(tool)

            # Preservar mayor confianza
            if finding.get("confidence", 0) > existing.get("confidence", 0):
                unique[key]["confidence"] = finding["confidence"]

    return list(unique.values())

def _severity_rank(self, severity: str) -> int:
    """Convierte severidad textual a valor numérico para comparación."""
    ranks = {
        "critical": 4,
        "high": 3,
        "medium": 2,
        "low": 1,
        "informational": 0
    }
    return ranks.get(severity.lower() if severity else "", 0)
4.7 Soluciones a Desafíos Técnicos Encontrados¶
El desarrollo de MIESC enfrentó varios desafíos técnicos escasamente documentados en la literatura. Esta sección relata los problemas encontrados y las soluciones adoptadas, con el objetivo de facilitar el trabajo de futuros investigadores.
4.7.1 Incompatibilidad de Manticore con Python 3.11¶
La primera dificultad surgió con Manticore, cuya importación fallaba al adoptar Python 3.11 como base de MIESC:
El origen no estaba en Manticore, sino en una de sus dependencias: la biblioteca wasm utiliza collections.Callable, un alias eliminado en Python 3.10 tras su deprecación en 3.3 (la migración a collections.abc se documenta junto a PEP 585; van Rossum et al., 2019). Ese cambio trasladó las clases de tipado de collections a collections.abc para dejar en claro que se trata de clases base abstractas, de modo que todo código heredado que las importa desde su ubicación anterior deja de funcionar. La solución adoptada fue un parche aplicado en tiempo de instalación que corrige únicamente el archivo afectado:
# Script de instalación: scripts/patch_wasm.py
import site
import os

site_packages = site.getsitepackages()[0]
wasm_types_path = os.path.join(site_packages, 'wasm', 'types.py')

if os.path.exists(wasm_types_path):
    with open(wasm_types_path, 'r') as f:
        content = f.read()

    # Aplicar parche
    patched = content.replace(
        'isinstance(cur_field, collections.Callable)',
        'isinstance(cur_field, collections.abc.Callable)'
    )

    with open(wasm_types_path, 'w') as f:
        f.write(patched)
La decisión sigue el principio de encapsulación de Parnas (1972), que aconseja aislar los cambios en un único punto: el parche modifica solo ese archivo y deja intacto el resto del sistema.
4.7.2 Containerización de Herramientas Legacy¶
Oyente planteó un problema de otra naturaleza: requiere versiones antiguas de sus dependencias (solc 0.4.x, z3 4.5.x), incompatibles con los entornos modernos de desarrollo, y el intento de instalarla junto con Slither y Mythril en el mismo entorno virtual terminaba en conflictos de dependencias. La solución fue ejecutarla en un contenedor Docker aislado:
class OyenteAdapter(ToolAdapter):
    """
    Adaptador para Oyente ejecutado en Docker.

    Oyente fue una de las primeras herramientas de análisis de smart
    contracts (Luu et al., 2016), pero sus dependencias antiguas la
    hacen incompatible con entornos modernos.

    La solución Docker proporciona aislamiento completo de dependencias
    mientras mantiene la capacidad de detectar ciertos patrones
    históricos que herramientas más modernas no cubren.
    """

    DOCKER_IMAGE = "luongnguyen/oyente"

    def analyze(self, contract_path: str, **kwargs) -> Dict[str, Any]:
        """
        Ejecuta Oyente en contenedor Docker.

        El montaje de volumen permite que Oyente acceda al contrato
        sin copiar archivos dentro del contenedor.
        """
        if not self._docker_available():
            return self._unavailable_response("Docker not installed")

        contract_dir = os.path.dirname(os.path.abspath(contract_path))
        contract_file = os.path.basename(contract_path)

        cmd = [
            "docker", "run", "--rm",
            "-v", f"{contract_dir}:/data:ro",  # Montaje read-only
            "--memory", "2g",  # Límite de memoria
            "--cpus", "1",  # Límite de CPU
            self.DOCKER_IMAGE,
            "-s", f"/data/{contract_file}",
            "-j"  # Salida JSON
        ]

        try:
            result = subprocess.run(
                cmd,
                capture_output=True,
                timeout=kwargs.get("timeout", 300),
                text=True
            )
            return self._parse_oyente_output(result.stdout)
        except subprocess.TimeoutExpired:
            return self._error_response("Docker container timeout")
4.7.3 Migración a Backend Local de IA¶
El tercer desafío fue de índole distinta. GPTScan y las herramientas similares requieren claves de API de OpenAI, lo que implica un costo económico de aproximadamente $0.03-0.12 por análisis, la transmisión del código fuente a servidores externos y la dependencia de la disponibilidad de un servicio de terceros. Según los estándares DPGA (2023), el software de interés público debe estar "libre de barreras de costo" y ser "respetuoso de la privacidad", y el uso obligatorio de APIs comerciales contradice ambos principios. La respuesta fue migrar la capa de IA a Ollama, que ejecuta los modelos de lenguaje localmente:
# Antes (requería API key y transmitía código):
import openai
response = openai.ChatCompletion.create(
    model="gpt-4",
    messages=[{"role": "user", "content": prompt}]
)

# Después (completamente local):
result = subprocess.run(
    ["ollama", "run", "llama3.2:3b", prompt],
    capture_output=True,
    text=True
)
Touvron et al. (2023) muestran que los modelos de pesos abiertos de 7B parámetros alcanzan un rendimiento competitivo en tareas de análisis de código, y la evidencia propia sugiere que la distancia respecto de los modelos frontier es más acotada de lo que suele asumirse: en la evaluación sobre EVMBench —corrida en la línea v5.x (§5.3.5)—, un modelo de pesos abiertos (DeepSeek-R1) registra la mayor precisión y F1 de la comparación bajo el matcher laxo, una estimación optimista que no habilita un ranking confiable de proveedores, y su única desventaja medida, un menor recall en una sola pasada, se recupera con un auto-ensemble de bajo costo. A cambio de ese compromiso se obtiene soberanía de datos y un costo que va de nulo, en la ejecución local, a aproximadamente $0.08 por auditoría con un modelo de pesos abiertos alojado en un servicio de terceros. El Capítulo 6 desarrolla este argumento y, en el corpus de la tesis, cuantifica también su costo: la configuración completamente local quedó por debajo de la frontier (44% frente a 72%, §5.3.4).
4.8 Caso de Estudio: Análisis de VulnerableBank¶
Para ilustrar el funcionamiento de MIESC de manera concreta, se desarrolló un contrato con vulnerabilidades conocidas sobre el que puede seguirse el recorrido completo del framework.
4.8.1 Contrato de Prueba¶
Listado 4.1. Contrato VulnerableBank con vulnerabilidad de reentrancy
// SPDX-License-Identifier: MIT
pragma solidity ^0.8.19;

/**
 * @title VulnerableBank
 * @notice Contrato de demostración con vulnerabilidad SWC-107
 * @dev Implementa el antipatrón de llamada externa antes de actualización
 *      de estado, permitiendo ataque de reentrancy
 */
contract VulnerableBank {
    mapping(address => uint256) public balances;
    uint256 public totalDeposits;

    event Deposit(address indexed user, uint256 amount);
    event Withdrawal(address indexed user, uint256 amount);

    function deposit() public payable {
        require(msg.value > 0, "Deposit must be greater than 0");
        balances[msg.sender] += msg.value;
        totalDeposits += msg.value;
        emit Deposit(msg.sender, msg.value);
    }

    /**
     * @notice Función vulnerable a reentrancy
     * @dev VULNERABILIDAD: La llamada externa (línea 35) ocurre ANTES
     *      de la actualización de estado (línea 39). Un atacante puede
     *      re-entrar a esta función durante la ejecución de call(),
     *      retirando fondos múltiples veces antes de que el balance
     *      se actualice a cero.
     */
    function withdraw() public {
        uint256 balance = balances[msg.sender];
        require(balance > 0, "No balance to withdraw");

        // LÍNEA 35: Llamada externa - punto de vulnerabilidad
        (bool success, ) = msg.sender.call{value: balance}("");
        require(success, "Transfer failed");

        // LÍNEA 39: Actualización de estado - demasiado tarde
        balances[msg.sender] = 0;
        totalDeposits -= balance;

        emit Withdrawal(msg.sender, balance);
    }
}
4.8.2 Resultados del Análisis Multi-Capa¶
La Tabla 4.4 presenta los resultados del análisis de VulnerableBank con MIESC.
Tabla 4.4. Resultados del análisis de VulnerableBank por capa (ejemplo ilustrativo de una corrida acotada durante el desarrollo; no corresponde a la corrida de evaluación del Capítulo 5, cuyos conteos para este contrato son 47→16, Figura 5.4)
| Capa | Herramienta | Tiempo (s) | Hallazgos | Reentrancy Detectado |
|---|---|---|---|---|
| 1 | Slither | 1.2 | 3 | Sí (High) |
| 1 | Solhint | 0.8 | 5 | No (estilo) |
| 2 | Echidna | 45.3 | 1 | Sí (invariante) |
| 3 | Mythril | 67.2 | 2 | Sí (Critical) |
| 3 | Manticore | 180.5 | 1 | Sí (High) |
| 5 | SMTChecker | 12.4 | 1 | Sí (Warning) |
| 7 | GPTScan | 8.7 | 2 | Sí (Critical) |
En conjunto, las herramientas produjeron 15 hallazgos brutos, que la deduplicación redujo a 6 únicos: una tasa del 60% en este contrato (la cifra del corpus completo es 68%, §5.4.1). El caso muestra con claridad la función de ese proceso: seis herramientas distintas detectaron la misma vulnerabilidad de reentrancy, que sin deduplicación aparecería seis veces en el reporte, y MIESC la consolida en una única entrada con detected_by: ["slither", "echidna", "mythril", "manticore", "smtchecker", "gptscan"].
4.8.3 Remediación Recomendada¶
El hallazgo consolidado incluye la remediación recomendada basada en el patrón Checks-Effects-Interactions (ConsenSys, 2023):
function withdraw() public nonReentrant {  // Modificador adicional
    uint256 balance = balances[msg.sender];
    require(balance > 0, "No balance to withdraw");

    // CORRECCIÓN: Actualizar estado ANTES de llamada externa
    balances[msg.sender] = 0;
    totalDeposits -= balance;

    // Llamada externa después de actualización de estado
    (bool success, ) = msg.sender.call{value: balance}("");
    require(success, "Transfer failed");

    emit Withdrawal(msg.sender, balance);
}
4.9 Interfaces de Usuario¶
4.9.1 Diseño Multi-Interfaz¶
MIESC implementa múltiples interfaces para atender diferentes casos de uso, siguiendo el principio de separación de responsabilidades (Dijkstra, 1982):
Tabla 4.5. Interfaces de MIESC y sus casos de uso
| Interfaz | Tecnología | Caso de Uso Principal | Usuario Típico |
|---|---|---|---|
| CLI | Python/Click | Automatización, scripts | DevOps, CI/CD |
| Dashboard HTML | Jinja2/HTML estático | Reportes reproducibles | Auditores |
| REST API | Django REST | Integración local con sistemas | Desarrolladores |
| MCP Server | Model Context Protocol | Asistentes IA | Claude, usuarios finales |
4.9.2 Integración CI/CD¶
La integración con pipelines de CI/CD permite automatizar auditorías de seguridad como parte del flujo de desarrollo:
# .github/workflows/security-audit.yml
name: Smart Contract Security Audit

on: [push, pull_request]

jobs:
  miesc-audit:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v6

      - name: Setup Python
        uses: actions/setup-python@v4
        with:
          python-version: '3.11'

      - name: Install MIESC
        run: |
          pip install miesc
          ollama pull llama3.2:3b

      - name: Run Security Audit
        run: |
          miesc audit contracts/ \
            --layers 1,2,3,7 \
            --format sarif \
            --output results.sarif

      - name: Upload SARIF to GitHub Security
        uses: github/codeql-action/upload-sarif@v4
        with:
          sarif_file: results.sarif
4.10 Referencias del Capítulo¶
Amdahl, G. M. (1967). Validity of the single processor approach to achieving large scale computing capabilities. Proceedings of the AFIPS Spring Joint Computer Conference, 483-485.
Atzei, N., Bartoletti, M., & Cimoli, T. (2017). A survey of attacks on Ethereum smart contracts. POST 2017, 164-186.
Baldoni, R., Coppa, E., D'Elia, D. C., Demetrescu, C., & Finocchi, I. (2018). A survey of symbolic execution techniques. ACM Computing Surveys, 51(3), 1-39.
Berners-Lee, T., Hendler, J., & Lassila, O. (2001). The semantic web. Scientific American, 284(5), 34-43.
Clarke, E. M., Henzinger, T. A., Veith, H., & Bloem, R. (Eds.). (2018). Handbook of model checking. Springer.
ConsenSys. (2023). Smart contract best practices. https://consensys.github.io/smart-contract-best-practices/
de Moura, L., & Bjørner, N. (2008). Z3: An efficient SMT solver. TACAS 2008, 337-340.
Digital Public Goods Alliance. (2023). Digital Public Goods Standard. https://digitalpublicgoods.net/standard/
Dijkstra, E. W. (1982). On the role of scientific thought. Selected Writings on Computing, 60-66.
Durieux, T., Ferreira, J. F., Abreu, R., & Cruz, P. (2020). Empirical review of automated analysis tools on 47,587 Ethereum smart contracts. ICSE 2020, 530-541.
Feist, J., Grieco, G., & Groce, A. (2019). Slither: A static analysis framework for smart contracts. WETSEB 2019, 8-15.
Fellegi, I. P., & Sunter, A. B. (1969). A theory for record linkage. JASA, 64(328), 1183-1210.
Gamma, E., Helm, R., Johnson, R., & Vlissides, J. (1994). Design patterns: Elements of reusable object-oriented software. Addison-Wesley.
Grieco, G., Song, W., Cygan, A., Feist, J., & Groce, A. (2020). Echidna: Effective, usable, and fast fuzzing for smart contracts. ISSTA 2020, 557-560.
Hohpe, G., & Woolf, B. (2003). Enterprise integration patterns. Addison-Wesley.
King, J. C. (1976). Symbolic execution and program testing. Communications of the ACM, 19(7), 385-394.
Linux Foundation. (2024). SPDX License List. https://spdx.org/licenses/
Luu, L., Chu, D. H., Olickel, H., Saxena, P., & Hobor, A. (2016). Making smart contracts smarter. CCS 2016, 254-269.
Martin, R. C. (2017). Clean architecture: A craftsman's guide to software structure and design. Prentice Hall.
Miller, B. P., Fredriksen, L., & So, B. (1990). An empirical study of the reliability of UNIX utilities. Communications of the ACM, 33(12), 32-44.
MITRE. (2024). Common Weakness Enumeration (CWE). https://cwe.mitre.org/
OASIS. (2020). Static Analysis Results Interchange Format (SARIF). https://docs.oasis-open.org/sarif/
Ollama. (2024). Ollama: Get up and running with large language models locally. https://ollama.ai/
Oman, P. W., & Hagemeister, J. (1992). Metrics for assessing a software system's maintainability. ICSM 1992, 337-344.
OWASP. (2023). OWASP Smart Contract Top 10. https://owasp.org/www-project-smart-contract-top-10/
Parnas, D. L. (1972). On the criteria to be used in decomposing systems into modules. Communications of the ACM, 15(12), 1053-1058.
Preston-Werner, T. (2013). Semantic Versioning 2.0.0. https://semver.org/
Rameder, H., Di Angelo, M., & Salzer, G. (2022). Review of automated vulnerability analysis of smart contracts on Ethereum. Frontiers in Blockchain, 5, 814977.
Schneier, B. (2000). Secrets and lies: Digital security in a networked world. Wiley.
SCSVS. (2023). Smart Contract Security Verification Standard. https://github.com/securing/SCSVS
Shaw, M. (2012). The role of design spaces. IEEE Software, 29(1), 46-50.
Sun, Y., Wu, D., Xue, Y., Liu, H., Wang, H., Xu, Z., Xie, X., & Liu, Y. (2024). GPTScan: Detecting logic vulnerabilities in smart contracts by combining GPT with program analysis. En Proceedings of the IEEE/ACM 46th International Conference on Software Engineering (ICSE '24) (pp. 1-13). ACM. https://doi.org/10.1145/3597503.3639117
Touvron, H., et al. (2023). LLaMA: Open and efficient foundation language models. arXiv:2302.13971.
Trail of Bits. (2024). Slither documentation. https://github.com/crytic/slither
van Rossum, G., & Warsaw, B. (2001b). PEP 3119 – Introducing abstract base classes. Python Enhancement Proposals.
van Rossum, G., et al. (2019). PEP 585 – Type hinting generics in standard collections. Python Enhancement Proposals.