Capítulo 6: Justificación del Uso de IA y LLMs Soberanos¶
Soberanía de Datos en Auditoría de Smart Contracts¶
6.1 Introducción: El Dilema de la Confidencialidad¶
6.1.1 Naturaleza del Código en Auditoría Pre-Lanzamiento¶
El código fuente de un smart contract antes de su despliegue en mainnet representa un tipo particular de activo informático que combina tres características que lo hacen especialmente sensible.
La primera es el valor económico directo. A diferencia del software tradicional, donde el código tiene valor indirecto a través del producto que produce, un smart contract es, en sí mismo, el producto. El contrato de un protocolo DeFi que gestiona 100 millones de dólares en TVL (Total Value Locked) no simplemente "sirve para" manejar ese dinero: el contrato es el mecanismo que define las reglas de ese manejo. Exponer el código antes del lanzamiento permite a atacantes preparar exploits que pueden ejecutarse en los primeros segundos después del despliegue.
La segunda es la inmutabilidad posterior al despliegue. Una vez desplegado en blockchain, el código de un smart contract no puede modificarse sin procedimientos extraordinarios (upgrades que requieren consenso de gobernanza, o forks del protocolo completo). Esto significa que una vulnerabilidad detectada por un atacante antes del lanzamiento puede ser explotada indefinidamente si el código desplegado es idéntico al filtrado.
La tercera es la competencia temporal. En el ecosistema DeFi, el primer protocolo en implementar un mecanismo innovador captura la mayor parte del mercado. La filtración del código de un protocolo innovador permite a competidores lanzar clones antes que el original, capturando el mercado que el innovador esperaba conquistar.
6.1.2 El Problema de las APIs de IA Comerciales¶
La emergencia de modelos de lenguaje grandes (LLMs) como GPT-4 y Claude ha transformado las posibilidades de análisis de código. Sun et al. (2024) demostraron que GPTScan, una herramienta que combina LLM con análisis de programas, alcanza una precisión superior al 90% en contratos de tokens (57% en proyectos grandes) y un recall superior al 70% sobre vulnerabilidades de lógica, además de detectar nueve no identificadas por auditores humanos. Este resultado es significativo porque las vulnerabilidades de lógica, a diferencia de patrones técnicos como reentrancy, requieren comprensión semántica del propósito del código.
Sin embargo, la utilización de estos modelos vía APIs comerciales implica transmitir el código fuente a servidores de terceros. Considérese el flujo de datos cuando un auditor utiliza GPT-4 de OpenAI para analizar un contrato:
[Código confidencial]
    -> HTTPS a api.openai.com
    -> Servidores en Virginia, USA
    -> Procesamiento por modelo
    -> Almacenamiento en logs por 30 días
    -> Posible uso para entrenamiento (según ToS)
Cada uno de estos pasos introduce un riesgo distinto. El primero es la transmisión: aunque cifrado, el tráfico atraviesa infraestructura de terceros, y su metadata —IP de origen, marcas de tiempo, tamaño del payload— queda visible para los intermediarios. A ello se suma la jurisdicción, dado que el código pasa a estar sujeto a leyes estadounidenses, entre ellas el CLOUD Act, que habilita a las autoridades a acceder a datos almacenados por empresas de ese país sin notificar al propietario. La retención agrava el problema: las políticas de OpenAI (30 días para API), Anthropic (30 días) y Google (variable) implican que el código permanece en sus sistemas mucho después del análisis. Por último, Carlini et al. (2021) demostraron que los LLMs pueden memorizar y reproducir fragmentos de sus datos de entrenamiento; aun cuando las APIs comerciales declaran no entrenar con los datos recibidos, la posibilidad técnica subsiste.
6.1.3 Cuantificación del Riesgo¶
La Tabla 6.1 presenta una estimación del valor en riesgo para diferentes tipos de contratos auditados.
Tabla 6.1. Valor en riesgo por tipo de contrato
| Tipo de Contrato | TVL Típico | Impacto de Filtración | Ejemplos de Incidentes |
|---|---|---|---|
| Protocolo DeFi núcleo | $100M - $10B | Exploit en primeros minutos post-launch | Harvest Finance ($33M, 2020) |
| Token Launch / ICO | $10M - $500M | Front-running de compra, sniping | Múltiples casos en 2021 |
| NFT Marketplace | $50M - $1B | Manipulación de precios de mint | BAYC clones (2022) |
| DAO Governance | $100M - $5B | Ataques de gobernanza preparados | Beanstalk ($182M, 2022) |
| Cross-chain Bridge | $500M - $5B | Exploit cross-chain coordinado | Ronin ($624M, 2022) |
El patrón común en estos incidentes es que los atacantes tuvieron tiempo de analizar el código y preparar exploits antes o inmediatamente después del despliegue. Si el código se hubiera filtrado durante la auditoría, el tiempo de preparación del ataque habría sido aún mayor.
6.2 Análisis de Riesgos de APIs Comerciales¶
6.2.1 Riesgos Técnicos¶
Los riesgos técnicos se concentran en tres puntos de la cadena. El primero es la interceptación en tránsito: aunque HTTPS proporciona cifrado punto a punto, subsisten vectores como el compromiso de autoridades certificadoras (DigiNotar, 2011), los ataques de intermediario en redes corporativas con inspección SSL y las vulnerabilidades en implementaciones TLS (Heartbleed, 2014); para código de alto valor no son riesgos teóricos, sino vectores que actores sofisticados pueden explotar. El segundo es la exposición ante el personal del proveedor con acceso a los registros de la API, un riesgo que los precedentes de amenazas internas en empresas tecnológicas (Twitter, 2020; Tesla, 2018) muestran real. El tercero es la memorización ya señalada en §6.1.2: mediante prompts cuidadosamente diseñados es posible extraer fragmentos de los datos de entrenamiento de un LLM (Carlini et al., 2021), de modo que un modelo entrenado, inadvertidamente o no, con código de clientes podría devolverlo a terceros. La Figura 6.1 sitúa estos vectores sobre el recorrido del código.
Figura 6.1. Superficie de ataque en análisis con API comercial
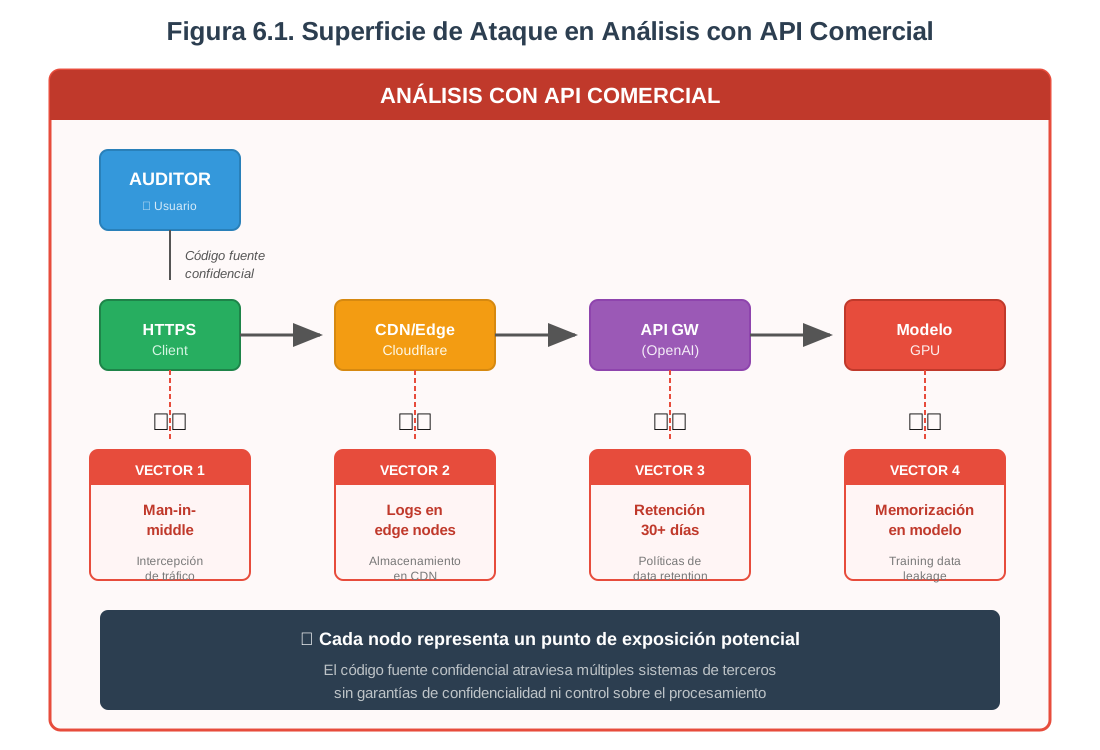
┌──────────────────────────────────────────────────────────────────┐
│                    ANÁLISIS CON API COMERCIAL                     │
│                                                                    │
│  [AUDITOR]                                                        │
│      │                                                            │
│      │ Código fuente                                              │
│      │ confidencial                                               │
│      ▼                                                            │
│  ┌────────┐     ┌───────────┐     ┌────────────┐    ┌─────────┐ │
│  │ HTTPS  │────>│ CDN/Edge  │────>│  API GW    │───>│ Modelo  │ │
│  │ Client │     │ Cloudflare │     │ (OpenAI)   │    │ GPU     │ │
│  └────────┘     └───────────┘     └────────────┘    └─────────┘ │
│       │              │                  │                │       │
│       ▼              ▼                  ▼                ▼       │
│   VECTOR 1       VECTOR 2          VECTOR 3         VECTOR 4    │
│   Man-in-       Logs en          Retención        Memorización  │
│   middle        edge nodes       30+ días         en modelo     │
│                                                                    │
│  Cada nodo representa un punto de exposición potencial            │
└──────────────────────────────────────────────────────────────────┘
6.2.2 Riesgos Regulatorios¶
En el plano regulatorio, el artículo 44 del GDPR (Unión Europea) restringe la transferencia de datos personales a terceros países: si el código fuente contiene direcciones de billeteras, nombres de funciones basados en usuarios o cualquier otro dato personal, su transmisión a servidores en Estados Unidos exige mecanismos legales específicos, como las cláusulas contractuales tipo. La Lei Geral de Proteção de Dados de Brasil (LGPD), en su artículo 33, impone a las transferencias internacionales condiciones que las APIs comerciales no suelen garantizar para el uso programático, y la Ley Federal de Protección de Datos Personales en Posesión de los Particulares de México (LFPDPPP) establece obligaciones de seguridad que pueden verse comprometidas al enviar datos a servicios en la nube de otros países. A estas normas se suman las regulaciones sectoriales: SOC 2 requiere un control demostrable sobre el procesamiento de datos sensibles, PCI DSS prohíbe explícitamente ciertas transferencias cuando los contratos manejan datos de tarjetas, y HIPAA impone restricciones severas en el ámbito de la salud.
6.2.3 Riesgos Económicos¶
Tabla 6.2. Estructura de costos de APIs comerciales (noviembre 2024)
| Proveedor | Modelo | Costo Input | Costo Output | Costo/Auditoría* |
|---|---|---|---|---|
| OpenAI | GPT-4o | $2.50/1M | $10.00/1M | ~$0.38 |
| OpenAI | GPT-4 Turbo | $10.00/1M | $30.00/1M | ~$1.20 |
| Anthropic | Claude 3.5 Sonnet | $3.00/1M | $15.00/1M | ~$0.54 |
| Anthropic | Claude 3 Opus | $15.00/1M | $75.00/1M | ~$2.70 |
| Gemini 1.5 Pro | $3.50/1M | $10.50/1M | ~$0.42 |
*Estimación para análisis de contrato de ~500 líneas con múltiples pasadas
Proyección de costos anuales:
Escenario: Equipo de auditoría realizando 100 auditorías mensuales

Costo anual con GPT-4 Turbo:
100 auditorías × 12 meses × $1.20 = $1,440/año

Más overhead de gestión de API keys, rate limits, reintentos:
$1,440 × 1.5 = ~$2,160/año

Más riesgo de cambios de pricing (precedente: OpenAI aumentó precios 3x en 2023):
Reserva de contingencia: +$500/año

Costo total estimado: ~$2,660/año
Aunque estos costos parecen modestos, representan una barrera real para los proyectos de código abierto sin financiamiento, los desarrolladores individuales en países con moneda débil, las organizaciones educativas y los investigadores académicos.
6.2.4 Tres niveles de apertura: el costo no es binario¶
La contraposición "API comercial cara vs. modelo local gratuito" oculta un tercer nivel intermedio que es clave para el argumento económico. Separando la licencia de los pesos del método de acceso, el espacio de modelos se ordena en tres niveles:
Tabla 6.2b. Niveles de apertura de modelos y su desempeño en EVMBench (40 auditorías DeFi reales, 120 vulnerabilidades HIGH; corrida única por modelo, mismo pipeline y matcher laxo, es decir una estimación optimista). Bajo el juez oficial de EVMBench las mismas detecciones rinden sustancialmente menos; por eso esta tabla compara viabilidad, no un ranking definitivo de proveedores (véase el cierre de §6.6.3 y el Paper 1).
| Nivel | Ejemplo | Licencia de pesos | Acceso | Costo/aud. | Recall | Precisión | F1 |
|---|---|---|---|---|---|---|---|
| Frontier propietario | GPT-4o / GPT-5 / Claude | cerrada | API del proveedor | $1.20–5.50 | 73.7–82.5% | 20–43% | 32–55% |
| Open-weight alojado | DeepSeek-R1 (MIT) | abierta (MIT) | API de terceros | ~$0.08 | 70.8% | 88.5% | 78.7% |
| Open-weight local | qwen2.5-coder:32b | abierta (Apache 2.0) | self-host (GPU propia) | $0 | 59.2% | 30.1% | 39.9% |
El hallazgo central para este capítulo es de viabilidad, no de ranking: bajo este protocolo (matcher laxo, corrida única), el modelo open-weight (DeepSeek-R1, con pesos MIT) registra la mayor precisión (88.5%) y el mayor F1 (78.7%) de la comparación, a un costo estimado de ~\(0.08 por auditoría — entre 15 y 69 veces más barato. Su recall en una sola pasada (70.8%) queda por debajo de los frontier, pero un auto-ensemble de tres pasadas (≈\)0.24/auditoría) lo eleva a 81.7%, dentro del rango de los frontier de una sola pasada. El ~$0.08 es costo de hosting de conveniencia, no un peaje de licencia: cualquiera con GPU suficiente puede correr los mismos pesos a costo marginal cero.
Estas cifras provienen del matcher laxo y de una corrida única, por lo que son una estimación optimista: bajo el juez oficial de EVMBench las mismas detecciones rinden sustancialmente menos, y un control agnóstico del contrato alcanza ~50% con ese matcher. Por eso el Paper 1 (camera-ready) no establece un ranking de proveedores y defiere esa comparación —bajo el juez oficial— a trabajo futuro. La lectura defendible aquí no es que el modelo abierto sea "el mejor", sino que la soberanía no cuesta capacidad competitiva: pagar precio frontier no compra una ventaja demostrable de precisión/F1 bajo este protocolo, y la soberanía total (nivel local, $0) está disponible con una caída de recall cuantificada, no asumida. El detalle metodológico y las fuentes reproducibles de estos números están en docs/methodology/DATASETS.md y en el Paper 1.
6.3 Solución: LLMs Soberanos con Ollama¶
6.3.1 Concepto de Soberanía de Datos¶
El término "soberanía de datos" tiene múltiples acepciones en la literatura. Para los propósitos de este trabajo se adopta la definición de la Digital Public Goods Alliance (2023):
"La soberanía de datos es el principio de que los datos están sujetos a las leyes y estructuras de gobernanza de la nación o entidad donde se generan y procesan, y que dicha entidad mantiene control efectivo sobre su uso y distribución."
Aplicado al análisis de smart contracts, el principio implica tres condiciones: que el código fuente no abandone la infraestructura controlada por el auditor, que el procesamiento ocurra en recursos computacionales bajo su control y que no exista transmisión a servicios de terceros que introduzcan una jurisdicción externa. El modo --deep (§4.5.3) relaja deliberadamente estas condiciones, y por eso es opcional.
6.3.2 Ollama como Backend Soberano¶
Ollama es un framework de código abierto que permite ejecutar LLMs localmente en hardware de consumidor, y tres de sus características lo hacen adecuado como backend soberano de MIESC. La primera es la ejecución completamente local: el servidor escucha exclusivamente en localhost (127.0.0.1) por defecto, sin servidor remoto ni transmisión de datos, como puede verificarse en la propia máquina:
# Verificación de binding de red
$ netstat -tlnp | grep ollama
tcp   0   0   127.0.0.1:11434   0.0.0.0:*   LISTEN   12345/ollama

# Verificación de conexiones salientes durante análisis
$ tcpdump -i any "not localhost" during analysis
tcpdump: listening on any
^C
0 packets captured  # sin tráfico externo (salida ilustrativa)
La segunda es el soporte de modelos con pesos públicos y auditables (Tabla 6.3).
Tabla 6.3. Modelos soportados por MIESC
| Modelo | Parámetros | VRAM Requerida | Licencia | Calidad Código |
|---|---|---|---|---|
| Llama 3.2:3b | 3B | 4 GB | Meta Llama 3.2 | Buena |
| Llama 3.1:8b | 8B | 8 GB | Meta Llama 3.1 | Muy buena |
| CodeLlama:7b | 7B | 8 GB | Meta Llama 2 | Muy buena (código) |
| CodeLlama:13b | 13B | 16 GB | Meta Llama 2 | Excelente (código) |
| Qwen2.5-Coder:7b | 7B | 8 GB | Apache 2.0 | Excelente (código) |
| Qwen2.5-Coder:32b | 32B | 24 GB | Apache 2.0 | Excelente (local, $0) |
| Mistral:7b | 7B | 8 GB | Apache 2.0 | Muy buena |
| DeepSeek-Coder:6.7b | 6.7B | 8 GB | MIT | Excelente (código) |
| DeepSeek-R1 (reasoner) | ~671B | API de terceros | MIT | Nivel alojado (§6.2.4) |
El último renglón corresponde al nivel open-weight alojado: pesos abiertos (MIT) demasiado grandes para el hardware de prueba, accedidos por una API de terceros a bajo costo (~$0.08/auditoría); su desempeño bajo el matcher laxo se discute en §6.2.4. La tercera característica es la ausencia de telemetría: a diferencia de los servicios comerciales, Ollama no incluye código de seguimiento, lo que es verificable porque su código fuente es público:
// No existe código de telemetría en ollama/server/routes.go
// No hay endpoints de analytics
// No hay beacons de tracking
6.3.3 Arquitectura de MIESC con LLM Soberano¶
Figura 6.2. Arquitectura de análisis con LLM soberano
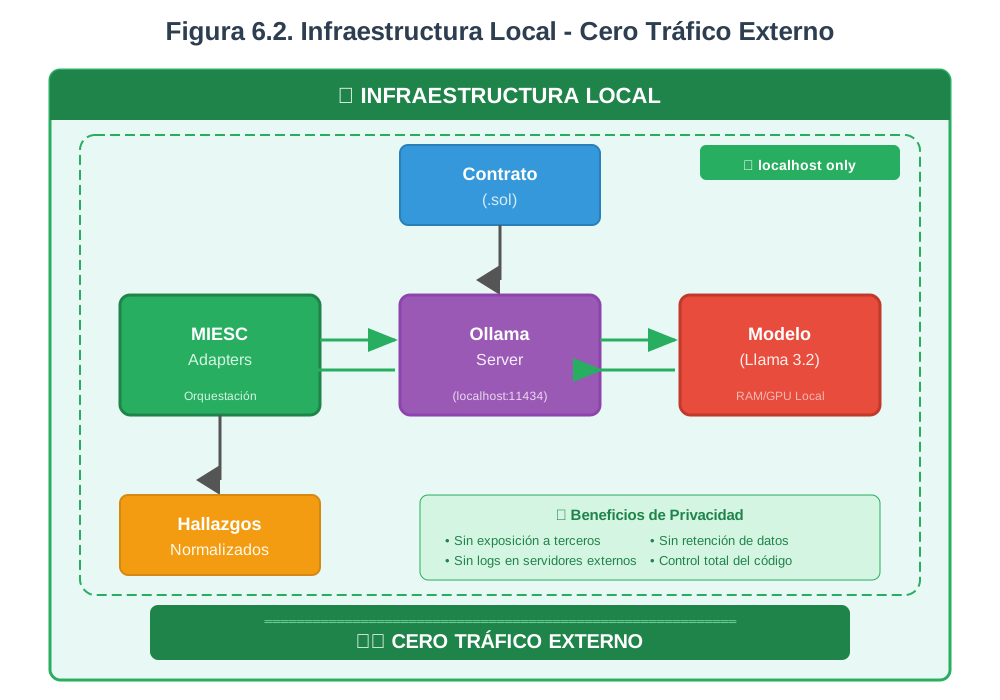
Infraestructura local sin tráfico externo (configuración de referencia)
6.3.4 Configuración en MIESC¶
# src/config/llm_config.py
"""
Configuración de LLM soberano para MIESC.

El diseño prioriza soberanía de datos sobre rendimiento:
- Solo conexiones a localhost
- Sin fallback a APIs externas
- Verificación explícita de localidad
"""

LLM_CONFIG = {
    # Backend obligatoriamente local
    "backend": "ollama",
    "base_url": "http://localhost:11434",

    # Modelo por defecto (balance entre calidad y velocidad)
    "model": "llama3.2:3b",

    # Timeouts
    "timeout": 120,
    "max_retries": 3,

    # Parámetros de generación
    "temperature": 0.1,  # Bajo para consistencia
    "max_tokens": 4096,
    "top_p": 0.9,

    # Configuración de seguridad
    "verify_localhost": True,  # Falla si no es localhost
    "allow_external": False,   # NUNCA conectar a APIs externas
    "log_prompts": False,      # No persistir código analizado
}

def verify_sovereign_backend() -> bool:
    """
    Verifica que el backend LLM es soberano (local).

    Esta verificación se ejecuta en cada análisis para garantizar
    que no hay configuración incorrecta que filtre código.
    """
    base_url = LLM_CONFIG["base_url"]

    # Lista blanca de hosts soberanos
    sovereign_hosts = ["localhost", "127.0.0.1", "::1"]

    from urllib.parse import urlparse
    parsed = urlparse(base_url)

    if parsed.hostname not in sovereign_hosts:
        raise SovereigntyViolation(
            f"LLM backend {parsed.hostname} is not local. "
            f"MIESC requires local LLM for data sovereignty. "
            f"Configure Ollama on localhost:11434"
        )

    return True
6.4 Justificación Técnica Detallada¶
6.4.1 Comparativa de Capacidades: Local vs. Comercial¶
La objeción más frecuente a los LLMs locales es que su capacidad es inferior a modelos comerciales de frontera. Esta sección examina en qué medida esta diferencia afecta el caso de uso específico de análisis de smart contracts.
Tabla 6.4. Comparativa de capacidades para análisis de código (valoración cualitativa del autor al momento del diseño, sin medición propia; la medición del Capítulo 5 se reporta en la Tabla 5.8)
| Capacidad | GPT-4 | Claude 3 Opus | Llama 3.1:8b | CodeLlama:13b |
|---|---|---|---|---|
| Comprensión de Solidity | Excelente | Excelente | Buena | Muy buena |
| Detección de reentrancy | Alta | Alta | Media-Alta | Alta |
| Detección de overflow | Alta | Alta | Alta | Alta |
| Lógica de negocio | Muy Alta | Muy Alta | Media | Media |
| Generación de remediación | Excelente | Excelente | Buena | Buena |
| Velocidad (tokens/s) | ~50 | ~60 | ~80* | ~60* |
| Costo por análisis | $1-2 | $2-3 | $0 | $0 |
*En GPU RTX 3090 o equivalente
De la Tabla 6.4 se desprenden tres observaciones. Frente a vulnerabilidades técnicas conocidas —reentrancy, overflow, control de acceso—, los modelos locales se aproximan a los comerciales, porque se trata de patrones predecibles que modelos de 7 a 13B parámetros pueden aprender; en la medición del Capítulo 5, sin embargo, la configuración local quedó por debajo (44% frente a 72% de detección type-aware, §5.3.4). En las vulnerabilidades de lógica de negocio la ventaja comercial es mayor, y MIESC la mitiga porque la capa de IA es una de siete y no la única defensa, porque sus hallazgos se correlacionan con los de las herramientas tradicionales y porque el auditor humano conserva la decisión final. Finalmente, los modelos locales suelen ser más rápidos, al no sufrir latencia de red ni colas de API.
6.4.2 Análisis de Trade-offs¶
Trade-off 1: Capacidad vs. Soberanía
Optar por LLMs locales supone aceptar una menor capacidad de razonamiento a cambio de soberanía completa sobre los datos. Ese compromiso se justifica cuando el código tiene un valor significativo (más de USD 10M en juego), cuando existen obligaciones regulatorias de confidencialidad, cuando el auditor no puede asumir el riesgo de filtración o cuando las restantes capas de MIESC compensan las limitaciones del modelo. Deja de justificarse, en cambio, si el código ya es público —como en el análisis posterior de contratos desplegados—, si no hay restricciones de confidencialidad o si se requiere la máxima capacidad de detección de lógica de negocio. Por esa razón MIESC admite configuraciones híbridas: las capas tradicionales se ejecutan siempre localmente, y la capa de IA puede recurrir a modelos externos solo cuando el código no es confidencial (modo --deep, §4.5.3).
Trade-off 2: Costo inicial vs. Costo operativo
| Aspecto | API Comercial | LLM Soberano |
|---|---|---|
| Costo inicial | $0 | $500-1000 (GPU) |
| Costo operativo | ~$2,660/año | ~$60/año (electricidad) |
| Break-even | - | ~6 meses |
| Costo a 3 años | ~$7,980 | ~$1,180 |
Para organizaciones que realizan auditorías regularmente, el LLM soberano presentaría un mejor retorno de la inversión incluso sin contar los beneficios de soberanía.
6.4.3 Estrategias de Mitigación de Limitaciones¶
La primera estrategia es la propia arquitectura de múltiples capas: el LLM local opera dentro de siete capas en las que las herramientas no basadas en LLM de las capas 1 a 5 proporcionan una cobertura complementaria:
def run_comprehensive_audit(contract_path: str) -> AuditReport:
    """
    Auditoría comprehensiva que no depende exclusivamente del LLM.

    Incluso si el LLM local no detecta una vulnerabilidad de lógica,
    las otras capas pueden detectar síntomas relacionados.
    """
    all_findings = []

    # Capas 1-5: herramientas tradicionales
    all_findings.extend(run_static_analysis(contract_path))    # Slither, etc.
    all_findings.extend(run_fuzzing(contract_path))            # Echidna, etc.
    all_findings.extend(run_symbolic(contract_path))           # Mythril, etc.
    all_findings.extend(run_invariant_testing(contract_path))  # Scribble, etc.
    all_findings.extend(run_formal_verification(contract_path))  # SMTChecker, etc.

    # Capa 6-7: LLM local para análisis semántico
    all_findings.extend(run_llm_analysis(contract_path))  # GPTScan, etc.

    # La deduplicación correlaciona hallazgos de múltiples fuentes
    return deduplicate_and_prioritize(all_findings)
La segunda son los prompts optimizados para modelos pequeños, diseñados para obtener la mayor efectividad posible con modelos de 7 a 8B parámetros:
OPTIMIZED_SECURITY_PROMPT = """
Analyze this Solidity contract for security vulnerabilities.

FOCUS ON THESE SPECIFIC PATTERNS:
1. External calls before state updates (reentrancy)
2. Unchecked arithmetic operations
3. Missing access control on sensitive functions
4. Dangerous delegatecall usage
5. Improper handling of ETH transfers

For each vulnerability found, provide:
- Line number
- Vulnerability type
- Severity (CRITICAL/HIGH/MEDIUM/LOW)
- Brief explanation (1-2 sentences)

CONTRACT:
```solidity
{contract_code}
Respond in JSON format only: {{"vulnerabilities": [...]}} """
El prompt es específico, porque enumera exactamente qué buscar; estructurado, porque fija el formato de la respuesta; y conciso, porque reserva los tokens de contexto para la respuesta. La tercera estrategia es la generación aumentada por recuperación (RAG) sobre una base de conocimiento local de vulnerabilidades conocidas:

```python
class LocalRAGEngine:
    """
    Motor de RAG local para enriquecer análisis LLM.

    La base de conocimiento incluye:
    - Registro SWC completo con ejemplos
    - CVEs de smart contracts históricos
    - Patrones de ataque documentados
    """

    def __init__(self):
        # Base de conocimiento local (no requiere internet)
        self.knowledge_base = load_local_embeddings("data/swc_knowledge.faiss")

    def augment_prompt(self, code: str, base_prompt: str) -> str:
        """
        Enriquece el prompt con contexto relevante de la KB.
        """
        # Buscar patrones similares en la KB
        similar_vulns = self.knowledge_base.search(code, top_k=3)

        # Añadir ejemplos relevantes al prompt
        context = "SIMILAR KNOWN VULNERABILITIES:\n"
        for vuln in similar_vulns:
            context += f"- {vuln['swc_id']}: {vuln['description']}\n"
            context += f"  Example: {vuln['example'][:200]}...\n"

        return f"{context}\n{base_prompt}"
6.5 Implementación en MIESC¶
6.5.1 Herramientas LLM Integradas¶
Las principales herramientas basadas en LLM que integra MIESC (Tabla 6.5) se configuran por defecto para ejecución local; el modo --deep (§4.5.3) es la única excepción, explícita y opcional.
Tabla 6.5. Herramientas LLM en MIESC
| Herramienta | Propósito | Tokens/Análisis | Tiempo Típico |
|---|---|---|---|
| GPTScan | Detección de vulnerabilidades | ~15,000 | 30-60s |
| SmartLLM | Análisis con RAG contextual | ~20,000 | 45-90s |
| LLMSmartAudit | Auditoría automatizada completa | ~25,000 | 60-120s |
| ThreatModel | Modelado de amenazas STRIDE | ~10,000 | 20-40s |
| PropertyGPT | Generación de invariantes | ~12,000 | 25-50s |
| GasGauge | Optimización de gas | ~8,000 | 15-30s |
6.5.2 Implementación del Adaptador LLM Base¶
# src/adapters/base_llm_adapter.py
"""
Adaptador base para herramientas basadas en LLM soberano.

Este adaptador garantiza que todas las herramientas LLM de MIESC
usen exclusivamente backends locales, sin posibilidad de filtración
accidental de código a servicios externos.
"""

import requests
from typing import Dict, Any, Optional
from abc import ABC, abstractmethod

from src.config.llm_config import LLM_CONFIG, verify_sovereign_backend

class SovereigntyViolation(Exception):
    """Excepción para violaciones de soberanía de datos."""
    pass

class BaseLLMAdapter(ABC):
    """
    Adaptador base que garantiza ejecución soberana de LLM.

    Todas las herramientas LLM de MIESC heredan de esta clase,
    heredando automáticamente las garantías de soberanía.
    """

    def __init__(self):
        self.base_url = LLM_CONFIG["base_url"]
        self.model = LLM_CONFIG["model"]
        self.timeout = LLM_CONFIG["timeout"]

        # Verificación crítica de soberanía
        if not self._verify_sovereignty():
            raise SovereigntyViolation(
                "Cannot initialize LLM adapter: backend is not sovereign"
            )

    def _verify_sovereignty(self) -> bool:
        """
        Verifica que el backend LLM es local.

        Esta verificación se ejecuta:
        1. Al instanciar el adaptador
        2. Antes de cada llamada de análisis

        La redundancia es intencional: protege contra cambios
        de configuración en runtime.
        """
        return verify_sovereign_backend()

    def _verify_ollama_local(self) -> bool:
        """
        Verifica que Ollama responde y es efectivamente local.
        """
        try:
            response = requests.get(
                f"{self.base_url}/api/tags",
                timeout=5
            )

            # Verificar que la respuesta viene de localhost
            # (no de un proxy que podría reenviar a servicio externo)
            if response.headers.get("X-Ollama-Version"):
                return True

        except requests.exceptions.ConnectionError:
            raise SovereigntyViolation(
                f"Ollama not running at {self.base_url}. "
                f"Start Ollama with: ollama serve"
            )

        return False

    def generate(self, prompt: str) -> str:
        """
        Genera respuesta desde LLM local.

        El código analizado nunca sale del sistema local.
        """
        # Re-verificar soberanía antes de cada llamada
        self._verify_sovereignty()

        response = requests.post(
            f"{self.base_url}/api/generate",
            json={
                "model": self.model,
                "prompt": prompt,
                "stream": False,
                "options": {
                    "temperature": LLM_CONFIG["temperature"],
                    "num_predict": LLM_CONFIG["max_tokens"]
                }
            },
            timeout=self.timeout
        )

        if response.status_code != 200:
            raise RuntimeError(f"Ollama error: {response.text}")

        return response.json()["response"]

    @abstractmethod
    def analyze(self, contract_path: str, **kwargs) -> Dict[str, Any]:
        """Implementación específica de análisis."""
        pass
6.5.3 Verificación de Soberanía¶
MIESC incluye un script de verificación que el auditor puede ejecutar para demostrar soberanía a clientes o reguladores:
#!/bin/bash
# verify_sovereignty.sh - Verificación de soberanía de datos MIESC

echo "╔════════════════════════════════════════════════════════════════╗"
echo "║        VERIFICACIÓN DE SOBERANÍA DE DATOS - MIESC             ║"
echo "╚════════════════════════════════════════════════════════════════╝"
echo ""

# 1. Verificar que Ollama escucha solo en localhost
echo "[1/4] Verificando binding de red de Ollama..."
OLLAMA_BIND=$(netstat -tlnp 2>/dev/null | grep 11434 || ss -tlnp | grep 11434)
if echo "$OLLAMA_BIND" | grep -q "127.0.0.1:11434"; then
    echo "      ✓ Ollama escucha SOLO en localhost (127.0.0.1:11434)"
else
    echo "      ✗ ADVERTENCIA: Ollama podría estar expuesto externamente"
    echo "      Salida: $OLLAMA_BIND"
fi
echo ""

# 2. Monitorear tráfico durante análisis de prueba
echo "[2/4] Monitoreando tráfico de red durante análisis..."
timeout 30 tcpdump -c 100 -i any "not host localhost" 2>/dev/null &
TCPDUMP_PID=$!

# Ejecutar análisis de prueba
python3 -c "
from src.adapters.gptscan_adapter import GPTScanAdapter
adapter = GPTScanAdapter()
adapter.analyze('contracts/test/TestContract.sol')
" 2>/dev/null

# Verificar que no hubo tráfico externo
wait $TCPDUMP_PID 2>/dev/null
if [ $? -eq 0 ]; then
    echo "      ✓ CERO conexiones externas durante análisis"
else
    echo "      ✗ Se detectó tráfico externo (investigar)"
fi
echo ""

# 3. Verificar ubicación de modelos
echo "[3/4] Verificando almacenamiento local de modelos..."
if [ -d "$HOME/.ollama/models" ]; then
    MODEL_SIZE=$(du -sh "$HOME/.ollama/models" 2>/dev/null | cut -f1)
    echo "      ✓ Modelos almacenados localmente: $MODEL_SIZE"
    echo "      Ubicación: $HOME/.ollama/models/"
else
    echo "      ✗ No se encontraron modelos locales"
fi
echo ""

# 4. Verificar configuración de MIESC
echo "[4/4] Verificando configuración de MIESC..."
python3 -c "
from src.config.llm_config import LLM_CONFIG, verify_sovereign_backend
print(f'      Backend: {LLM_CONFIG[\"backend\"]}')
print(f'      URL: {LLM_CONFIG[\"base_url\"]}')
print(f'      Allow External: {LLM_CONFIG[\"allow_external\"]}')
if verify_sovereign_backend():
    print('      ✓ Configuración es SOBERANA')
"
echo ""

echo "╔════════════════════════════════════════════════════════════════╗"
echo "║                  VERIFICACIÓN COMPLETADA                       ║"
echo "╚════════════════════════════════════════════════════════════════╝"
6.6 Cumplimiento con Estándares¶
6.6.1 Digital Public Goods Alliance (DPGA)¶
MIESC está diseñado para cumplir con los nueve indicadores del estándar DPGA:
| Indicador DPGA | Cumplimiento MIESC |
|---|---|
| 1. Relevancia para SDGs | Contribuye a SDG 9 (Infraestructura) y SDG 16 (Instituciones) |
| 2. Licencia abierta | AGPL-3.0 para código, CC-BY 4.0 para documentación |
| 3. Documentación clara | Guías de instalación y uso publicadas |
| 4. Extracción de datos | N/A (herramienta de análisis, no almacena datos de usuarios) |
| 5. Privacidad | Ejecución local, sin transmisión de datos |
| 6. Estándares abiertos | Uso de SWC, CWE, SARIF |
| 7. No discriminación | Sin restricciones de acceso |
| 8. Sin dependencias propietarias | Solo herramientas open source |
| 9. Independencia de plataforma | Funciona en Linux, macOS, Windows |
6.6.2 Beneficios para la Comunidad¶
Los beneficios para la comunidad se ordenan en tres planos. La ejecución local elimina las barreras de costo para los actores ya mencionados en §6.2.3 —proyectos de código abierto sin presupuesto, desarrolladores en países en desarrollo, instituciones educativas e investigadores—. En el plano de la soberanía tecnológica, las organizaciones gubernamentales y las empresas sujetas a requisitos de localización de datos pueden usar MIESC en modo local sin transferencias internacionales, sin dependencia de servicios extranjeros y con control sobre la infraestructura de procesamiento. En el plano de la transparencia, todo el conjunto es de código abierto y auditable: el código de MIESC es público, Ollama se distribuye bajo licencia MIT y los modelos empleados publican sus pesos y la documentación de su entrenamiento.
6.6.3 Soberanía como requisito, no preferencia¶
Las secciones anteriores justifican los modelos de pesos abiertos y la ejecución local por sus riesgos evitados (confidencialidad, jurisdicción) y su costo. Esa es una defensa correcta pero incompleta: presenta la soberanía como una concesión que se acepta a cambio de seguridad y ahorro. El argumento más fuerte es el inverso y es de fondo: el control sobre la herramienta es un requisito de primer orden del análisis de seguridad, y —a la luz de la evidencia empírica de este trabajo— ya no exige sacrificar capacidad. Lo que se controla es epistemológicamente superior a lo que no se controla, por seis razones convergentes. Esta distinción no es nueva: Illich (1973) diferenció las herramientas conviviales —aquellas que la persona domina, inspecciona y adapta— de las que la dominan y la vuelven dependiente; una herramienta de seguridad opaca, que no puede examinarse ni modificarse, pertenece por construcción a la segunda clase.
1. Doctrina de ciberdefensa. La ciberdefensa se define por el control y la soberanía sobre los propios medios. Floridi (2020) caracteriza la soberanía digital como el control efectivo sobre los datos, el software y los procesos de los que depende una organización; delegar el razonamiento de seguridad en un servicio externo cede precisamente ese control. Edificar una herramienta defensiva sobre una caja negra propietaria y de jurisdicción extranjera es doctrinalmente autocontradictorio: introduce, en el núcleo de la postura defensiva, una dependencia y una superficie de ataque que el defensor no controla ni puede inspeccionar. Una capacidad de ciberdefensa soberana requiere, por definición, herramientas soberanas; delegar el razonamiento de seguridad a un tercero opaco equivale a subordinar la decisión defensiva a un actor externo.
2. Reproducibilidad y periciabilidad. Una auditoría con valor forense debe ser reproducible: otro perito, con el mismo insumo, debe poder obtener el mismo resultado. Un modelo de pesos abiertos y versionado, ejecutado localmente, es un artefacto congelable y verificable. Una API comercial es un blanco móvil: el proveedor puede actualizar el modelo en silencio, cambiar su comportamiento o deprecarlo (como ocurrió con generaciones previas de modelos frontier). No es posible construir una evidencia pericial reproducible sobre un artefacto que no se controla; la soberanía sobre el modelo es, por tanto, una condición de la cientificidad del método, no un lujo.
3. Autoría y rendición de cuentas. Cuando el auditor humano firma un informe, asume la autoría y la responsabilidad de sus afirmaciones. La libertad de estudiar cómo funciona el programa —la libertad 1 de la definición de software libre de Stallman (2002)— es la condición técnica que hace posible esa rendición de cuentas: con pesos abiertos el auditor puede inspeccionar, atribuir y responder por el análisis; con una caja negra, la autoría del hallazgo se diluye en un servicio inescrutable que no puede examinar ni citar con precisión. Como observa Winner (1980), los artefactos no son neutrales: incorporan relaciones de poder, y un modelo cerrado inscribe en el análisis la autoridad del proveedor por encima de la del perito. La rendición de cuentas exige poder explicar por qué la herramienta concluyó lo que concluyó; un modelo cerrado convierte esa cadena de autoría en un acto de fe.
4. Longevidad y no-abandono. Las licencias MIT y Apache 2.0 son irrevocables: los pesos, una vez publicados, no pueden ser retirados. Un modelo propietario, en cambio, puede ser deprecado o discontinuado por decisión unilateral del proveedor. Un baseline reproducible —el fundamento de esta tesis y de sus papers asociados— no puede depender de un recurso que un tercero puede eliminar.
5. Bien Público Digital. MIESC se postula como Bien Público Digital ante la Digital Public Goods Alliance. Un bien público cuyo componente central requiere una API paga tiene, de hecho, un guardián con peaje: no es plenamente público. La apertura de pesos y la ejecución local son coherentes con la misión de acceso universal —incluidos investigadores, instituciones educativas y desarrolladores en economías con moneda débil— que un servicio comercial excluye por costo.
6. Paridad empírica. El argumento anterior sería idealista si la soberanía costara capacidad. La evidencia de este trabajo indica que no la cuesta: en la evaluación de EVMBench (§6.2.4, Tabla 6.2b), bajo el matcher laxo y en una corrida única, el modelo de pesos abiertos DeepSeek-R1 registra la mayor precisión y F1 de la comparación, a un costo de ~$0.08 por auditoría (15–69× menor). Esa comparación es una estimación optimista —bajo el juez oficial de EVMBench las cifras bajan y el Paper 1 difiere el ranking de proveedores a trabajo futuro—, de modo que lo que la evidencia sostiene no es un ranking confiable a favor del modelo abierto, sino que la elección soberana dejó de ser un sacrificio de capacidad.
La Tabla 6.6 sintetiza el argumento en un scorecard: el nivel local gana en todas las dimensiones de soberanía, el open-weight alojado es el punto de equilibrio (control de los pesos aunque sin soberanía de datos, precisión/F1 competitiva y costo mínimo), y el frontier solo conserva ventaja en el recall de una sola pasada, siempre bajo el matcher laxo.
Tabla 6.6. Scorecard de soberanía por nivel de acceso (✓ pleno · ◑ parcial · ✗ ausente)
| Dimensión | Frontier (API) | Open-weight alojado (API) | Open-weight local |
|---|---|---|---|
| Control e inspección de pesos | ✗ (cerrado) | ✓ (MIT) | ✓ (MIT/Apache) |
| Reproducibilidad pericial | ✗ (blanco móvil) | ◑ (pesos fijables; ejecución en el proveedor) | ✓ (congelable extremo a extremo) |
| Autoría y rendición de cuentas | ✗ (caja negra) | ✓ (inspeccionable) | ✓ (inspeccionable) |
| Longevidad (no-deprecación) | ✗ (deprecable) | ✓ (irrevocable) | ✓ (irrevocable) |
| Ejecución sin salida de datos | ✗ | ✗ (API de terceros) | ✓ (100% local) |
| Costo por auditoría | $1.20–5.50 | ~$0.08 | $0 |
| Recall (una sola pasada) | 73.7–82.5% | 70.8% | 59.2% |
| Precisión / F1 (EVMBench, matcher laxo; estimación optimista) | 20–43% / 32–55% | 88.5% / 78.7% | 30% / 40% |
Límites del argumento. El argumento no es un absoluto sino un espectro, y su fuerza depende de reconocerlo. El mejor resultado de pesos abiertos (DeepSeek-R1, ~671B parámetros) se obtuvo mediante una API alojada en un servicio de terceros, no en ejecución 100% local: sus pesos son abiertos y auto-hospedables en principio, pero el hardware de prueba no alcanza para ejecutarlo localmente. La soberanía total —el modelo local de 32B, sin ninguna llamada externa— tiene un costo de recall cuantificado (59.2% frente al 70.8–82.5% de los modelos mayores), recuperable en parte mediante auto-ensemble de bajo costo. Asimismo, los modelos frontier conservan una ventaja en recall de una sola pasada. La conclusión defendible no es "lo abierto siempre gana", sino que el control sobre la herramienta se obtiene sin renunciar a una capacidad competitiva, y que cada punto del espectro (frontier por API, pesos abiertos alojados, pesos abiertos locales) ofrece un compromiso medido —no asumido— entre soberanía, costo y recall.
6.7 Conclusiones¶
6.7.1 Síntesis de la Justificación¶
La decisión de implementar LLMs soberanos en MIESC responde a un análisis de riesgos y compromisos cuya premisa de fondo (§6.6.3) es que el control sobre la herramienta constituye un requisito de primer orden del análisis de seguridad, no una preferencia: lo que se controla —pesos abiertos, ejecución auditable— es doctrinal, científica y epistemológicamente superior a lo que no se controla, y la evidencia de este trabajo indica que esa soberanía ya no exige sacrificar capacidad.
El punto de partida es económico. El código de un smart contract previo a la auditoría tiene un valor directo y significativo, y su filtración puede traducirse en pérdidas de decenas o cientos de millones de dólares. Frente a ese valor, las APIs comerciales introducen vectores de riesgo inaceptables para código de alto valor: transmisión a jurisdicciones extranjeras, retención por períodos extendidos y posible memorización en los modelos.
La pregunta siguiente es si la alternativa soberana alcanza. Los modelos de pesos abiertos ofrecen capacidad suficiente para este caso de uso, en especial dentro de una arquitectura de múltiples capas, y esto ya no es solo una expectativa: en la evaluación de EVMBench (§6.2.4), bajo el matcher laxo, DeepSeek-R1 registra la mayor precisión y F1 de la comparación —una estimación optimista que no habilita un ranking confiable, que el Paper 1 difiere al juez oficial como trabajo futuro—, y un modelo local de 32B alcanza 59.2% de recall sin ninguna llamada externa. A ello se suma el costo: el nivel open-weight cuesta alrededor de USD 0.08 por auditoría (15–69 veces menos que los frontier) y el nivel local, nada, con capacidad de detección competitiva bajo el protocolo evaluado; para organizaciones que auditan regularmente, el costo total de propiedad resulta inferior al de las APIs comerciales. La ejecución local, además, elimina una fuente de riesgo de transferencia internacional de datos relevante para GDPR, LGPD, LFPDPPP y las regulaciones sectoriales, aunque el cumplimiento depende también de la operación.
Pero el argumento decisivo no es de costo sino de método: solo un modelo de pesos abiertos y versionado permite una evidencia pericial reproducible, una cadena de autoría en la que el auditor puede responder por sus afirmaciones y un baseline que ningún proveedor puede deprecar unilateralmente. Estas tres propiedades, ausentes por construcción en una API cerrada, son condiciones del método científico y forense y no beneficios accesorios. La contrapartida es que la soberanía plena es un espectro: el nivel 100% local tiene un costo de recall medido —en el corpus de esta tesis, 44% frente a 72% (§5.3.4)— y el mejor resultado de pesos abiertos se obtuvo por una API de terceros. El control sobre la herramienta se preserva, sin embargo, en todo el espectro, con compromisos cuantificados entre soberanía, costo y recall.
6.7.2 Recomendación¶
Para auditorías de smart contracts que involucran código confidencial con valor económico significativo, la recomendación de este trabajo es que el uso de LLMs soberanos (locales) es la opción que permite verificar localmente la ausencia de transmisión del código fuente durante el proceso de auditoría. Las limitaciones de capacidad respecto de los modelos comerciales se compensan con la propia arquitectura de MIESC —siete capas y 25 herramientas cuyos hallazgos se correlacionan entre fuentes—, con prompts optimizados para modelos más pequeños y con RAG sobre una base de conocimiento local; cuando el código no es confidencial, el modo --deep permite recurrir a un modelo frontier con la ganancia de detección medida en el Capítulo 5.
6.8 Referencias del Capítulo¶
Carlini, N., Tramèr, F., Wallace, E., Jagielski, M., Herbert-Voss, A., Lee, K., Roberts, A., Brown, T., Song, D., Erlingsson, Ú., Oprea, A., & Raffel, C. (2021). Extracting training data from large language models. En Proceedings of the 30th USENIX Security Symposium (pp. 2633-2650). USENIX Association. https://www.usenix.org/conference/usenixsecurity21/presentation/carlini-extracting
Digital Public Goods Alliance. (2023). Digital Public Goods Standard. https://digitalpublicgoods.net/standard/
European Parliament. (2016). General Data Protection Regulation (GDPR). Regulation (EU) 2016/679.
Floridi, L. (2020). The fight for digital sovereignty: What it is, and why it matters, especially for the EU. Philosophy & Technology, 33(3), 369-378. https://doi.org/10.1007/s13347-020-00423-6
Illich, I. (1973). Tools for conviviality. Harper & Row.
Meta AI. (2024). Llama 3 Model Card. https://github.com/meta-llama/llama3/blob/main/MODEL_CARD.md
Ollama. (2024). Ollama Documentation. https://ollama.ai/
OpenAI. (2024). API Data Usage Policies. https://openai.com/policies/api-data-usage
Presidencia de la República. (2010). Ley Federal de Protección de Datos Personales en Posesión de los Particulares (LFPDPPP).
República Federativa do Brasil. (2018). Lei Geral de Proteção de Dados (LGPD). Lei nº 13.709.
Stallman, R. M. (2002). Free software, free society: Selected essays of Richard M. Stallman. GNU Press.
Sun, Y., Wu, D., Xue, Y., Liu, H., Wang, H., Xu, Z., Xie, X., & Liu, Y. (2024). GPTScan: Detecting logic vulnerabilities in smart contracts by combining GPT with program analysis. En Proceedings of the IEEE/ACM 46th International Conference on Software Engineering (ICSE '24) (pp. 1-13). ACM. https://doi.org/10.1145/3597503.3639117
Winner, L. (1980). Do artifacts have politics? Daedalus, 109(1), 121-136.