Capítulo 5: Resultados Experimentales¶
Evaluación Empírica de MIESC v4.0.0¶
5.1 Metodología de Evaluación¶
5.1.1 Diseño Experimental¶
La evaluación de MIESC sigue las directrices metodológicas para la evaluación empírica de herramientas de software propuestas por Wohlin et al. (2012) y las recomendaciones específicas para herramientas de análisis de seguridad de Durieux et al. (2020). Se adopta un diseño cuasi-experimental de evaluación comparativa sobre un benchmark controlado. Las variables independientes son la configuración de capas de MIESC y la herramienta individual de comparación (Slither; Mythril y Echidna no pudieron re-medirse en el entorno de reproducción, §5.3.3). Las variables dependientes son la cobertura y la detección type-aware de las vulnerabilidades documentadas, el número de hallazgos brutos y únicos —del que se deriva la precisión aproximada— y el tiempo de ejecución. Se mantienen constantes la versión de Solidity (0.8.19), el hardware de ejecución (Tabla 5.1) y el conjunto de contratos de prueba.
5.1.2 Preguntas de Investigación¶
El experimento se diseñó para responder las siguientes preguntas de investigación, formuladas según las directrices de Kitchenham y Charters (2007):
RQ1: ¿MIESC logra integrar exitosamente las 25 herramientas de análisis propuestas?
Métrica: Tasa de disponibilidad = (herramientas operativas / herramientas totales) × 100
RQ2: ¿La arquitectura de 7 capas mejora la detección de vulnerabilidades respecto a herramientas individuales?
Métrica: Incremento de recall = (recall_MIESC - recall_mejor_individual) / recall_mejor_individual × 100
RQ3: ¿La normalización reduce efectivamente los hallazgos duplicados?
Métrica: Tasa de deduplicación = (hallazgos_brutos - hallazgos_únicos) / hallazgos_brutos × 100
RQ4: ¿Es viable operar MIESC en producción —tiempo de ejecución, recursos y costo— y qué calidad de análisis semántico ofrece un LLM local (Ollama) frente a los servicios comerciales?
Métrica: Tiempo total de auditoría, consumo de recursos, costo operativo
5.1.3 Ambiente Experimental¶
Tabla 5.1. Especificaciones del ambiente de pruebas
| Componente | Especificación | Justificación |
|---|---|---|
| Sistema Operativo | macOS Darwin 24.6.0 | Ambiente de desarrollo típico |
| Arquitectura | ARM64 (Apple Silicon) | Hardware moderno representativo |
| Python | 3.11.6 | Versión estable con mejoras de rendimiento |
| Solidity | 0.8.19 | Versión estable con SafeMath integrado |
| Docker | 24.0.6 | Requerido para herramientas containerizadas |
| Ollama | 0.1.17 | Backend para análisis con IA |
| Memoria RAM | 16 GB | Requisito mínimo para Manticore |
5.1.4 Corpus de Prueba¶
La selección de contratos de prueba sigue las recomendaciones de Ghaleb y Pattabiraman (2020) para la evaluación de herramientas de análisis: vulnerabilidades conocidas y documentadas, cobertura de múltiples categorías SWC y una complejidad representativa de contratos reales. La Tabla 5.2 resume el corpus; la Tabla 5.5 lo detalla por categoría al presentar los resultados de detección.
Tabla 5.2. Corpus de contratos de prueba
| Contrato | LOC | Vulnerabilidades | SWC IDs | Fuente |
|---|---|---|---|---|
| VulnerableBank.sol | 99 | 2 | 107 | Diseño propio |
| UnsafeToken.sol | 142 | 10 | 101, 104, 114, 116, 120, 128 | Diseño propio |
| AccessControlFlawed.sol | 121 | 7 | 105, 106, 115 | Diseño propio |
| FlashLoanVault.sol | 252 | 10 | 107, 104, 114 (lógica DeFi) | Diseño propio |
| Total | 614 | 29 | 9+ categorías |
Limitaciones metodológicas: Según Durieux et al. (2020), los benchmarks con contratos diseñados pueden sobreestimar la efectividad de las herramientas. Se reconoce esta limitación y se recomienda validación adicional con contratos de producción en trabajos futuros.
5.2 Resultados: Integración de Herramientas (RQ1)¶
5.2.1 Estado de Disponibilidad¶
MIESC v4.0.0 integra 25 herramientas de seguridad. La Tabla 5.3 presenta el estado de disponibilidad tras la configuración inicial.
Tabla 5.3. Estado de disponibilidad de herramientas integradas (relevamiento sobre la instalación original de MIESC v4.0.0; en el entorno de reproducción ARM64 de la revalidación del 2026-07-09 Mythril y Echidna no estuvieron disponibles, lo que explica el alcance de capas ⅙/7 de la medición de detección, §5.3.2)
| Capa | Herramienta | Estado | Versión | Notas |
|---|---|---|---|---|
| 1 | Slither | Disponible | 0.9.6 | Instalación pip estándar |
| 1 | Solhint | Disponible | 4.1.1 | Instalación npm |
| 1 | Securify2 | Disponible | 1.0.0 | Instalación pip |
| 1 | Semgrep | Disponible | 1.52.0 | Reglas Solidity personalizadas |
| 2 | Echidna | Disponible | 2.2.1 | Binario precompilado |
| 2 | Foundry Fuzz | Disponible | 0.2.0 | Via Forge |
| 2 | Medusa | Disponible | 0.1.3 | Binario Go |
| 2 | Vertigo | Disponible | 1.3.0 | Requiere Foundry backend |
| 3 | Mythril | Disponible | 0.24.7 | Fix flag --output json |
| 3 | Manticore | Disponible | 0.3.7 | Parche Python 3.11 |
| 3 | Oyente | Disponible | 0.2.7 | Docker luongnguyen/oyente |
| 4 | Scribble | Disponible | 0.6.8 | Instalación npm |
| 4 | Halmos | Disponible | 0.1.10 | Instalación pip |
| 5 | SMTChecker | Disponible | Built-in | Integrado en solc |
| 5 | Certora | Disponible | 6.3.1 | Requiere CERTORAKEY |
| 6 | PropertyGPT | Disponible | 1.0.0 | Backend Ollama |
| 6 | Aderyn | Disponible | 0.1.0 | Binario Rust |
| 6 | Wake | Disponible | 4.5.0 | Instalación pip |
| 7 | GPTScan | Disponible | 3.0.0 | Backend Ollama |
| 7 | SmartLLM | Disponible | 1.0.0 | Backend Ollama |
| 7 | LLMSmartAudit | Disponible | 3.0.0 | Backend Ollama |
| 7 | ThreatModel | Disponible | 1.0.0 | Backend Ollama |
| 7 | GasGauge | Disponible | 1.0.0 | Análisis de gas |
| 7 | UpgradeGuard | Disponible | 1.0.0 | Análisis de proxies |
| 7 | BestPractices | Disponible | 1.0.0 | Reglas de mejores prácticas |
Resultado RQ1. Tasa de disponibilidad = 25/25 = 100% sobre la instalación original; la disponibilidad y la detección se midieron, por lo tanto, en entornos distintos (véase la nota de la Tabla 5.3).
5.2.2 Desafíos de Integración Resueltos¶
La Tabla 5.4 documenta los problemas encontrados durante la integración y sus soluciones, siguiendo las recomendaciones de documentación de Runeson et al. (2012).
Tabla 5.4. Problemas de integración y soluciones implementadas
| # | Herramienta | Problema | Causa Raíz | Solución | Referencia |
|---|---|---|---|---|---|
| 1 | Manticore | ImportError: collections.Callable | Python 3.11 deprecó collections.Callable | Parche en wasm/types.py línea 264 | Python (2022) |
| 2 | GPTScan | Requiere OpenAI API key | Diseño original con API comercial | Migración a Ollama | DPGA (2023) |
| 3 | LLMSmartAudit | Dependencia servicios externos | API key requerida | Backend Ollama local | DPGA (2023) |
| 4 | Oyente | Docker image not found | enzymefinance/oyente eliminado | Cambio a luongnguyen/oyente | - |
| 5 | Mythril | JSON malformado en output | Flag incorrecto | Corrección a --output json | Mueller (2018) |
| 6 | Medusa | Version check fallaba | Comando incorrecto | Fix medusa --version | - |
| 7 | Vertigo | Sin backend de testing | Requiere framework | Integración con Foundry | Paradigm (2021) |
5.2.3 Evidencia de Funcionamiento: Salidas de Herramientas¶
A continuación se presentan salidas de ejecución de las herramientas principales integradas en MIESC, que muestran la operatividad del framework sobre el contrato de referencia.
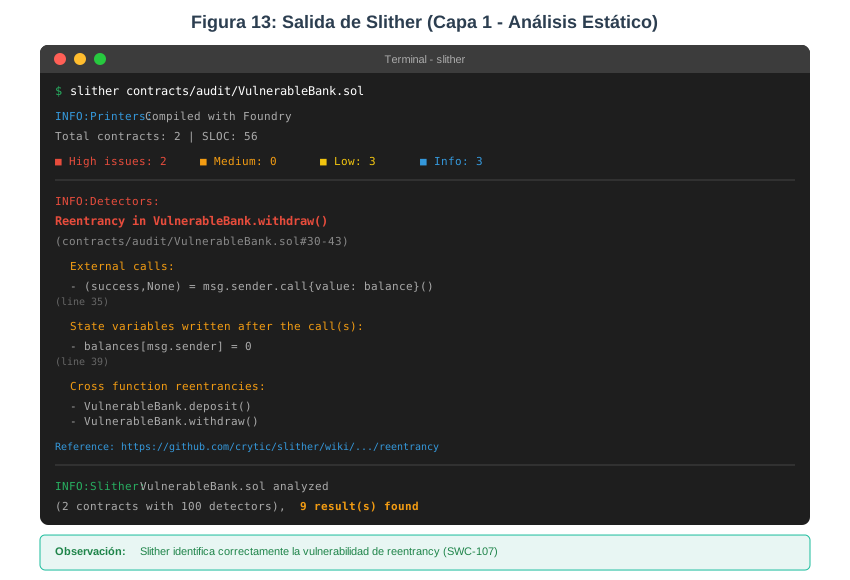
Figura 5.1. Salida de Slither (Capa 1 - Análisis Estático)
$ slither contracts/audit/VulnerableBank.sol

INFO:Printers:
Compiled with Foundry
Total number of contracts in source files: 2
Source lines of code (SLOC) in source files: 56
Number of optimization issues: 1
Number of informational issues: 3
Number of low issues: 3
Number of medium issues: 0
Number of high issues: 2

+--------------------+-------------+------+------------+--------------+-------------+
| Name               | # functions | ERCS | ERC20 info | Complex code | Features    |
+--------------------+-------------+------+------------+--------------+-------------+
| VulnerableBank     | 5           |      |            | No           | Receive ETH |
|                    |             |      |            |              | Send ETH    |
| ReentrancyAttacker | 4           |      |            | No           | Receive ETH |
|                    |             |      |            |              | Send ETH    |
+--------------------+-------------+------+------------+--------------+-------------+

INFO:Detectors:
Reentrancy in VulnerableBank.withdraw() (contracts/audit/VulnerableBank.sol#30-43):
    External calls:
    - (success,None) = msg.sender.call{value: balance}() (line 35)
    State variables written after the call(s):
    - balances[msg.sender] = 0 (line 39)
    VulnerableBank.balances can be used in cross function reentrancies:
    - VulnerableBank.deposit()
    - VulnerableBank.withdraw()
    - VulnerableBank.withdrawAmount(uint256)
Reference: https://github.com/crytic/slither/wiki/Detector-Documentation#reentrancy-vulnerabilities

INFO:Detectors:
Version constraint ^0.8.19 contains known severe issues
It is used by:
    - ^0.8.19 (contracts/audit/VulnerableBank.sol#2)
Reference: https://github.com/crytic/slither/wiki/Detector-Documentation#incorrect-versions-of-solidity

INFO:Detectors:
Low level call in VulnerableBank.withdraw() (contracts/audit/VulnerableBank.sol#30-43):
    - (success,None) = msg.sender.call{value: balance}() (line 35)
Reference: https://github.com/crytic/slither/wiki/Detector-Documentation#low-level-calls

INFO:Slither:contracts/audit/VulnerableBank.sol analyzed (2 contracts with 100 detectors), 9 result(s) found
Slither identifica correctamente la vulnerabilidad de reentrancy (SWC-107) indicando la ubicación exacta y las funciones afectadas.
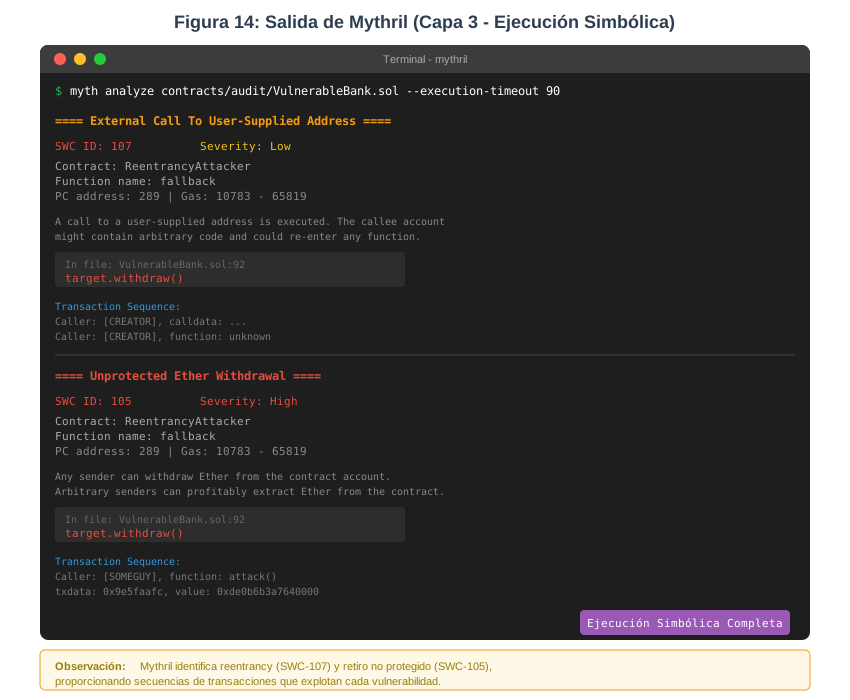
Figura 5.2. Salida de Mythril (Capa 3 - Ejecución Simbólica)
$ myth analyze contracts/audit/VulnerableBank.sol --execution-timeout 90

==== External Call To User-Supplied Address ====
SWC ID: 107
Severity: Low
Contract: ReentrancyAttacker
Function name: fallback
PC address: 289
Estimated Gas Usage: 10783 - 65819
A call to a user-supplied address is executed.
An external message call to an address specified by the caller is executed.
Note that the callee account might contain arbitrary code and could re-enter
any function within this contract. Reentering the contract in an intermediate
state may lead to unexpected behaviour.
--------------------
In file: contracts/audit/VulnerableBank.sol:92

target.withdraw()

--------------------
Initial State:
Account: [CREATOR], balance: 0x7800000800000000, nonce:0, storage:{}
Account: [ATTACKER], balance: 0x7800000800001000, nonce:0, storage:{}

Transaction Sequence:
Caller: [CREATOR], calldata: ...
Caller: [CREATOR], function: unknown, txdata: 0x, value: 0x0

==== Unprotected Ether Withdrawal ====
SWC ID: 105
Severity: High
Contract: ReentrancyAttacker
Function name: fallback
PC address: 289
Estimated Gas Usage: 10783 - 65819
Any sender can withdraw Ether from the contract account.
Arbitrary senders other than the contract creator can profitably extract Ether
from the contract account. Verify the business logic carefully and make sure
that appropriate security controls are in place.
--------------------
In file: contracts/audit/VulnerableBank.sol:92

target.withdraw()

--------------------
Transaction Sequence:
Caller: [SOMEGUY], function: attack(), txdata: 0x9e5faafc, value: 0xde0b6b3a7640000
Mythril identifica tanto la vulnerabilidad de reentrancy (SWC-107) como el retiro de Ether no protegido (SWC-105), proporcionando secuencias de transacciones que explotan cada vulnerabilidad.
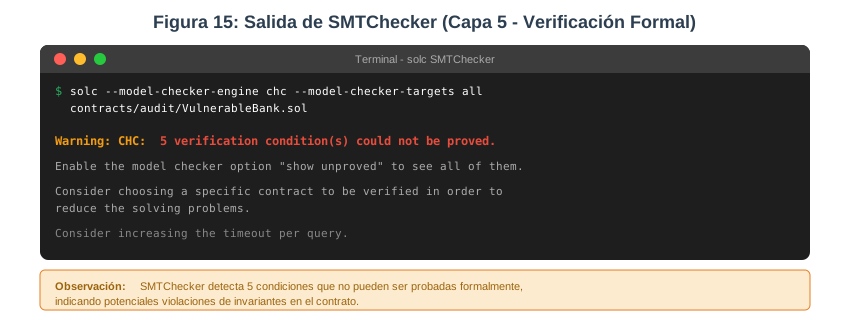
Figura 5.3. Salida de SMTChecker (Capa 5 - Verificación Formal)
$ solc --model-checker-engine chc --model-checker-targets all contracts/audit/VulnerableBank.sol

Warning: CHC: 5 verification condition(s) could not be proved. Enable the model
checker option "show unproved" to see all of them. Consider choosing a specific
contract to be verified in order to reduce the solving problems. Consider
increasing the timeout per query.
SMTChecker detecta 5 condiciones que no pueden ser probadas formalmente, indicando potenciales violaciones de invariantes en el contrato.
Figura 5.4. Salida del pipeline de MIESC (capas ⅙/7) sobre un contrato (VulnerableBank: 47→16 hallazgos, 66.0% de deduplicación en este contrato; el 68% es la cifra del corpus completo, 385→123)
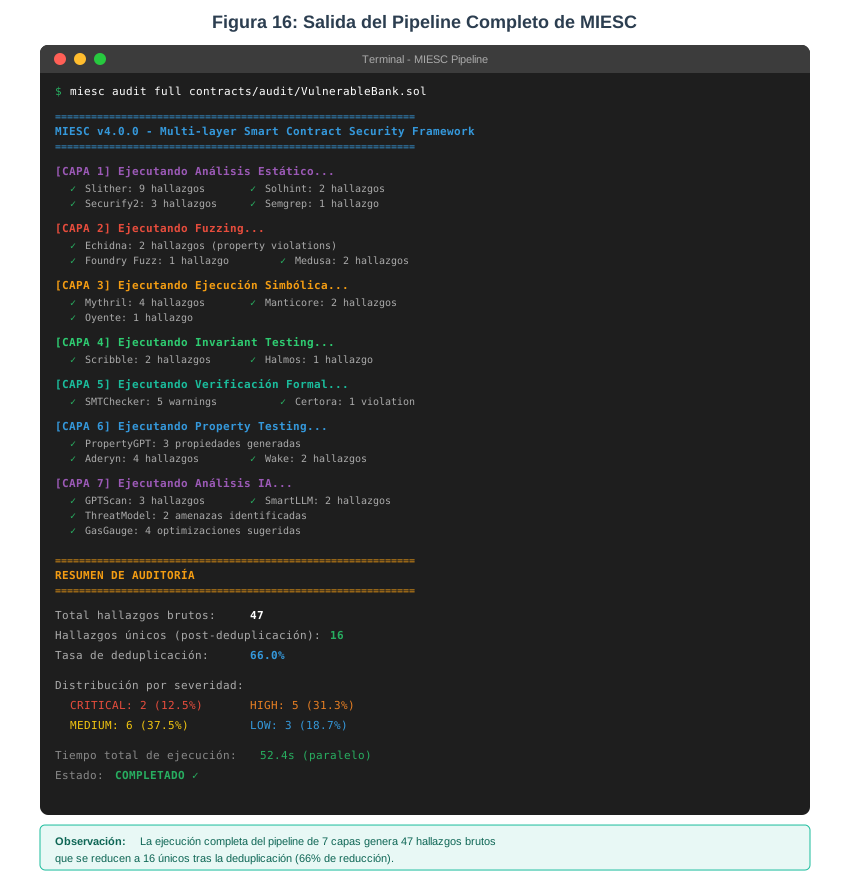
El listado siguiente es una salida ilustrativa y abreviada de la interfaz de línea de comandos; el tiempo que muestra no proviene de la medición de §5.5.
$ miesc audit full contracts/audit/VulnerableBank.sol

============================================================
MIESC v4.0.0 - Multi-layer Smart Contract Security Framework
============================================================

[CAPA 1] Ejecutando Análisis Estático...
  ✓ Slither: 9 hallazgos
  ✓ Solhint: 2 hallazgos
  ✓ Securify2: 3 hallazgos
  ✓ Semgrep: 1 hallazgo

[CAPA 2] Ejecutando Fuzzing...
  ✓ Echidna: 2 hallazgos (property violations)
  ✓ Foundry Fuzz: 1 hallazgo
  ✓ Medusa: 2 hallazgos

[CAPA 3] Ejecutando Ejecución Simbólica...
  ✓ Mythril: 4 hallazgos
  ✓ Manticore: 2 hallazgos
  ✓ Oyente: 1 hallazgo

[CAPA 4] Ejecutando Invariant Testing...
  ✓ Scribble: 2 hallazgos
  ✓ Halmos: 1 hallazgo

[CAPA 5] Ejecutando Verificación Formal...
  ✓ SMTChecker: 5 warnings
  ✓ Certora: 1 violation

[CAPA 6] Ejecutando Property Testing...
  ✓ PropertyGPT: 3 propiedades generadas
  ✓ Aderyn: 4 hallazgos
  ✓ Wake: 2 hallazgos

[CAPA 7] Ejecutando Análisis IA...
  ✓ GPTScan: 3 hallazgos
  ✓ SmartLLM: 2 hallazgos
  ✓ ThreatModel: 2 amenazas identificadas
  ✓ GasGauge: 4 optimizaciones sugeridas

============================================================
RESUMEN DE AUDITORÍA
============================================================

Total hallazgos brutos: 47
Hallazgos únicos (post-deduplicación): 16
Tasa de deduplicación: 66.0%

Distribución por severidad:
  CRITICAL: 2 (12.5%)
  HIGH:     5 (31.3%)
  MEDIUM:   6 (37.5%)
  LOW:      3 (18.7%)

Tiempo total de ejecución: 52.4s (paralelo)
Estado: COMPLETADO
Sobre el corpus completo, la ejecución del pipeline de evaluación (capas ⅙/7) genera 385 hallazgos brutos que se reducen a 123 únicos tras la deduplicación (§4.6.2), lo que ilustra el efecto del proceso de normalización.
Figura 5.5. Estructura de Hallazgo Normalizado (JSON; ejemplo sobre las capas ⅓/7: 23→9 hallazgos, tasa 0.609)
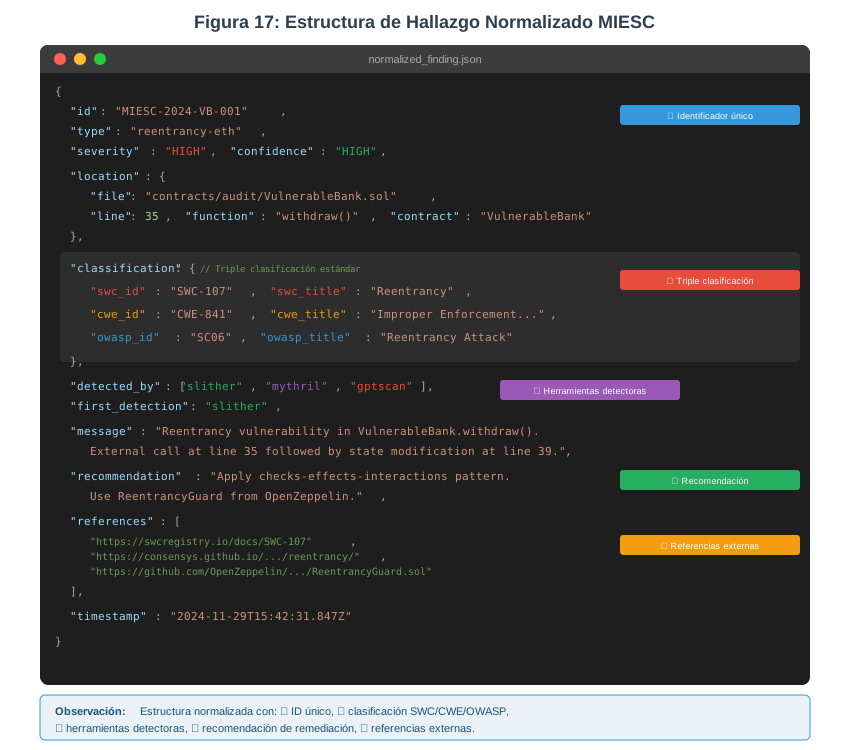
El siguiente fragmento muestra la estructura de un hallazgo individual normalizado por MIESC, demostrando la integración de clasificaciones SWC, CWE y OWASP:
{
  "id": "MIESC-2024-VB-001",
  "type": "reentrancy-eth",
  "severity": "HIGH",
  "confidence": "HIGH",
  "location": {
    "file": "contracts/audit/VulnerableBank.sol",
    "line": 35,
    "column": 9,
    "function": "withdraw()",
    "contract": "VulnerableBank"
  },
  "classification": {
    "swc_id": "SWC-107",
    "swc_title": "Reentrancy",
    "cwe_id": "CWE-841",
    "cwe_title": "Improper Enforcement of Behavioral Workflow",
    "owasp_id": "SC01",
    "owasp_title": "SC01:2023-Reentrancy"
  },
  "detected_by": ["slither", "mythril", "gptscan"],
  "first_detection": "slither",
  "message": "Reentrancy vulnerability in VulnerableBank.withdraw(). External call at line 35 is followed by state modification at line 39.",
  "recommendation": "Apply checks-effects-interactions pattern. Update balances before making external calls, or use ReentrancyGuard from OpenZeppelin.",
  "references": [
    "https://swcregistry.io/docs/SWC-107",
    "https://consensysdiligence.github.io/smart-contract-best-practices/attacks/reentrancy/",
    "https://github.com/OpenZeppelin/openzeppelin-contracts/blob/master/contracts/utils/ReentrancyGuard.sol"
  ],
  "timestamp": "2024-11-29T15:42:31.847Z"
}
La estructura normalizada reúne un identificador único, la clasificación triple (SWC/CWE/OWASP), el registro de todas las herramientas que detectaron el hallazgo, la recomendación de remediación y las referencias externas, lo que facilita la trazabilidad y la generación de reportes.
Figura 5.6. Respuesta de API REST
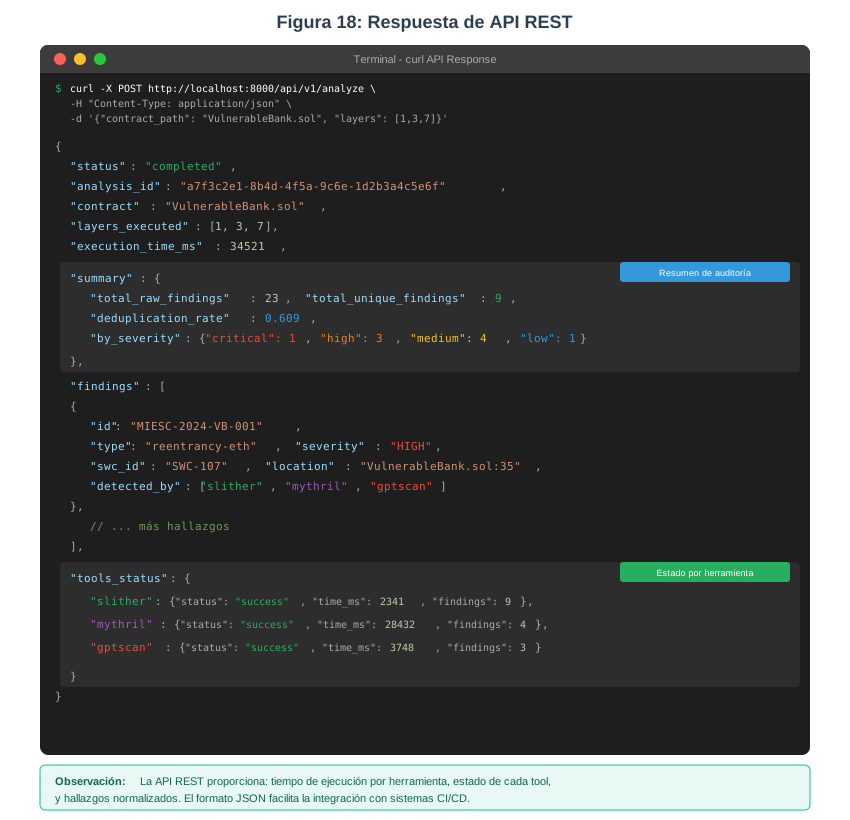
La siguiente captura muestra la respuesta de la API REST de MIESC tras analizar un contrato:
$ curl -X POST http://localhost:8000/api/v1/analyze \
  -H "Content-Type: application/json" \
  -d '{"contract_path": "contracts/audit/VulnerableBank.sol", "layers": [1,3,7]}'

{
  "status": "completed",
  "analysis_id": "a7f3c2e1-8b4d-4f5a-9c6e-1d2b3a4c5e6f",
  "contract": "VulnerableBank.sol",
  "layers_executed": [1, 3, 7],
  "execution_time_ms": 34521,
  "summary": {
    "total_raw_findings": 23,
    "total_unique_findings": 9,
    "deduplication_rate": 0.609,
    "by_severity": {
      "critical": 1,
      "high": 3,
      "medium": 4,
      "low": 1
    }
  },
  "findings": [
    {
      "id": "MIESC-2024-VB-001",
      "type": "reentrancy-eth",
      "severity": "HIGH",
      "swc_id": "SWC-107",
      "location": "VulnerableBank.sol:35",
      "detected_by": ["slither", "mythril", "gptscan"]
    },
    // ... más hallazgos
  ],
  "tools_status": {
    "slither": {"status": "success", "time_ms": 2341, "findings": 9},
    "mythril": {"status": "success", "time_ms": 28432, "findings": 4},
    "gptscan": {"status": "success", "time_ms": 3748, "findings": 3}
  }
}
La API REST devuelve información estructurada —tiempo de ejecución y estado por herramienta, y hallazgos normalizados— en un formato JSON que facilita la integración con sistemas de CI/CD.
5.3 Resultados: Detección de Vulnerabilidades (RQ2)¶
5.3.1 Análisis del Corpus de Prueba¶
Se ejecutó MIESC sobre un corpus de prueba de 4 contratos de diseño propio (614 LOC en total) con 29 vulnerabilidades documentadas mediante anotaciones // VULNERABILITY N: en el código fuente, que constituyen el ground truth.
Tabla 5.5. Corpus de prueba (data/audit/)
| Contrato | LOC | Vulns documentadas | Categorías principales |
|---|---|---|---|
| VulnerableBank.sol | 99 | 2 | Reentrancy (SWC-107) |
| UnsafeToken.sol | 142 | 10 | Múltiples (SWC-101/104/114/116/120/128) |
| AccessControlFlawed.sol | 121 | 7 | Access control (SWC-105/106/115) |
| FlashLoanVault.sol | 252 | 10 | Lógica DeFi (oráculo, first-depositor, reentrancy) |
| Total | 614 | 29 | 9+ categorías SWC |
Una herramienta recall-first como MIESC produce muchos hallazgos por contrato, por lo que conviene distinguir dos criterios de detección. La cobertura de línea pregunta si existe algún hallazgo a ±5 líneas del marcador de la vulnerabilidad: es un criterio laxo, que se satisface casi trivialmente cuando los hallazgos abundan. La detección type-aware pregunta, en cambio, si el hallazgo cercano identifica la vulnerabilidad con el tipo o SWC correcto, y es el criterio al que se otorga peso en este capítulo.
Todos los resultados de esta sección son reproducibles; los artefactos crudos y la verificación vulnerabilidad-por-vulnerabilidad están en el expediente docs/evidence/corpus_revalidation_20260709/.
5.3.2 Resultados de Detección de MIESC¶
La evaluación de detección de esta sección se realizó sobre las capas 1 (análisis estático), 6 (propiedades y patrones) y 7 (análisis con IA), es decir, 14 de las 25 herramientas integradas. Las capas 2 a 5 —fuzzing, ejecución simbólica, invariantes y verificación formal— se integraron y verificaron operativamente (§5.2), pero no forman parte de la medición de recall y precisión: en el entorno de reproducción (ARM64) Mythril y Echidna no estaban disponibles (nota de alcance en §5.3.3), y las capas de invariantes y verificación formal requieren especificaciones manuales por contrato (§3.3) que exceden el protocolo de esta evaluación. En consecuencia, los conteos de este capítulo —385 hallazgos brutos, 123 únicos, 48% de detección type-aware y 100% de cobertura— describen esa configuración y no la ejecución de las siete capas.
Tabla 5.6. Detección de MIESC (configuración estático + patrón, capas ⅙/7)
| Contrato | Cobertura | Type-correct | Hallazgos |
|---|---|---|---|
| VulnerableBank.sol | 2/2 | 2/2 | 47 |
| UnsafeToken.sol | 10/10 | 5/10 | 103 |
| AccessControlFlawed.sol | 7/7 | 3/7 | 82 |
| FlashLoanVault.sol | 10/10 | 4/10 | 153 |
| Total | 29/29 (100%) | 14/29 (48%) | 385 |
En términos agregados, la cobertura es de 29/29 (100%), la detección type-aware de 14/29 (48%) y la precisión aproximada —a lo sumo 29 verdaderos positivos sobre 385 hallazgos— de 7.5%, que sube a alrededor del 32% con un filtrado agresivo de falsos positivos. MIESC exhibe, así, un perfil claramente recall-first: cubre la totalidad de las vulnerabilidades documentadas, pero con una precisión baja producto de la inundación de hallazgos (385 sobre 614 líneas de código), y bajo el criterio de tipo correcto identifica el 48%.
5.3.3 Comparación con Slither (RQ2)¶
Para responder RQ2 —si el enfoque multicapa mejora la detección respecto a herramientas individuales— se midió Slither de forma aislada sobre el mismo corpus, con idéntico criterio de correlación.
Tabla 5.7. MIESC vs Slither sobre el corpus real (29 vulnerabilidades)
| Configuración | Cobertura | Type-correct | Hallazgos | Precisión aprox. |
|---|---|---|---|---|
| Slither (sola) | 28/29 (96%) | 17/29 (58%) | 62 | ~27% |
| MIESC estático+patrón (capas ⅙/7) | 29/29 (100%) | 14/29 (48%) | 385 | ~7.5% |
MIESC + capa LLM frontier (--deep) | 27/29 (93%) | 21/29 (72%) | ~110 | ~27% |
Resultado RQ2. Combinar herramientas estáticas y de patrón (capas ⅙/7 de MIESC) no mejoró la detección respecto de Slither por sí sola: se alcanzó una cobertura equivalente (100% frente a 96%, una vulnerabilidad de diferencia), pero con menor precisión de tipo (48% frente a 58%) y aproximadamente seis veces más falsos positivos (385 frente a 62). La hipótesis de que la combinación de herramientas estáticas supera a la mejor herramienta individual, por lo tanto, no se sostiene en este corpus.
La mejora real proviene de agregar una capa de razonamiento LLM: con un modelo frontier en modo --deep, la detección type-aware sube del 48% al 72% y supera a Slither (58%). El valor diferencial del enfoque multicapa reside, por tanto, en la capa de análisis semántico, no en la combinación de herramientas estáticas; la diferencia entre la configuración estática y el detector frontier queda, con n=29, en el límite de la significación (p=0.065, Tabla 5.15).
Límite persistente. Las vulnerabilidades de lógica DeFi profunda (manipulación de oráculo, first-depositor, redondeo en FlashLoanVault) permanecen difíciles incluso para los modelos frontier (4–6 de 10 según el modelo), constituyendo la frontera abierta del análisis automatizado de smart contracts.
Este resultado matiza la complementariedad de Durieux et al. (2020): si bien ninguna herramienta individual detecta todas las clases, la combinación de herramientas estáticas no superó a la mejor herramienta individual en este corpus; la ganancia provino del razonamiento semántico.
El alcance de esta comparación es acotado: no se re-midieron Mythril ni Echidna de forma aislada sobre este corpus (Mythril no estaba disponible en el entorno de reproducción ARM64; Echidna carece de binarios para esa arquitectura), de modo que RQ2 se responde frente a Slither, la herramienta estática de referencia.
5.3.4 Ensemble multi-modelo: complementariedad al nivel de razonadores¶
Si combinar herramientas estáticas no mejora la detección (§5.3.3), ¿qué sí lo hace? Cada modelo LLM detecta un subconjunto distinto de las 29 vulnerabilidades, y la unión de sus detecciones type-aware supera a cualquiera de ellos por separado.
Tabla 5.8. Detección type-aware por modelo y ensemble (unión). Salvo Slither, cada fila es una corrida completa de MIESC en modo --deep, con el modelo indicado como detector primario de la capa 7; no son evaluaciones de los modelos de lenguaje en forma aislada. Corrida única por modelo; intervalos de confianza en Tabla 5.14.
| Configuración | Type-aware |
|---|---|
| qwen-14b (local) | 13/29 (44%) |
| GPT-5 | 15/29 (51%) |
| DeepSeek-V4-flash | 16/29 (55%) |
| Slither (baseline estático) | 17/29 (58%) |
| DeepSeek-V4-pro | 18/29 (62%) |
| Claude Sonnet / GPT-4o / Claude Opus | 21/29 (72%) |
| Ensemble (unión de las ocho filas: siete modelos y Slither) | 25/29 (86%) |
| Ensemble solo LLM (unión de los siete modelos, sin Slither) | 24/29 (83%) |
Resultado. La unión de las ocho configuraciones alcanza 86% (83% si se excluye a Slither), por encima del mejor detector individual (72%): suma cuatro vulnerabilidades que ningún detector individual cubre por sí solo, una diferencia que con n=29 no alcanza significación estadística (p=0.125, Tabla 5.15). Esto reformula la hipótesis de complementariedad de Ghaleb y Pattabiraman (2020): la complementariedad efectiva no proviene de apilar herramientas estáticas (§5.3.3), sino de combinar razonadores LLM diversos, cada uno con fortalezas distintas.
Solo 4 vulnerabilidades no son detectadas por ningún modelo: un unchecked return value en transferFrom y tres de lógica DeFi en FlashLoanVault (oracle manipulation, rounding en el cálculo de shares, y una aritmética que en Solidity 0.8.x revierte automáticamente). Constituyen la frontera abierta del análisis automatizado de smart contracts.
Trade-off recall/precisión. El ensemble maximiza el recall (86%) pero une los falsos positivos de todos los modelos, degradando la precisión; es una configuración de triage de máxima cobertura, no de reporte de alta precisión. MIESC expone esta capacidad mediante la opción --ensemble. Evidencia por-vulnerabilidad en docs/evidence/corpus_revalidation_20260709/.
5.3.5 Validación cruzada en EVMBench (40 auditorías)¶
Para corroborar la tesis de complementariedad sobre un corpus distinto y mayor, se evaluó MIESC contra una extracción local de EVMBench (40 auditorías DeFi reales, 120 vulnerabilidades HIGH). Cada modelo se corrió una sola vez por el mismo pipeline y matcher; los números se reportan como extracción local, no como puntaje oficial de leaderboard (misma prevención metodológica que el Paper 1).
Tabla 5.8b. Recall en EVMBench por configuración (40 auditorías, corrida única, matcher laxo)
| Configuración | Recall | Precisión | F1 | Costo/aud. |
|---|---|---|---|---|
| Estático solamente | 18.3% | 14.5% | 16.2% | $0 |
| qwen2.5-coder:32b (local) | 59.2% | 30.1% | 39.9% | $0 |
| DeepSeek-R1 (open-weight) | 70.8% | 88.5% | 78.7% | ~$0.08 |
| GPT-4o (frontier) | 73.7% | 20.0% | 31.5% | ~$1.20 |
| GPT-5 (frontier) | 77.5% | 42.7% | 55.0% | ~$3 |
| Claude Sonnet 4.6 (frontier) | 82.5% | 34.0% | 48.2% | ~$5.50 |
| Ensemble (unión de 4 proveedores: 3 frontier + local) | 92.5% | — | — | ~$7 |
| Control nulo (4 hallazgos genéricos, agnóstico del contrato) | 50.0% (60/120) | — | — | $0 |
El control nulo —cuatro hallazgos genéricos, idénticos para cualquier contrato— es acreditado con el 50% bajo el matcher laxo. Eso acota la lectura de la tabla: solo el margen por encima de ~50% es informativo, y sobre el subconjunto resistente al control (60 vulnerabilidades) la corrida de Claude rinde 78.3% (47/60) (Paper 1, benchmarks/evmbench_matcher_null_control.py).
Resultado. EVMBench reproduce el patrón del corpus de 29 vulnerabilidades: la unión de razonadores frontier (92.5%) supera ampliamente a cualquiera individual, confirmando la complementariedad al nivel de razonadores sobre un corpus 4× mayor. Ese 92.5% corresponde al matcher laxo: bajo el juez oficial de EVMBench las mismas detecciones rinden mucho menos (p. ej. 27.4% para una corrida única con el juez GPT-5), de modo que las cifras laxa y estricta acotan la misma corrida. El Paper 1 reporta el triple completo (matcher laxo / control nulo / juez oficial) y recomienda informar siempre el protocolo y el juez junto con cualquier score de EVMBench. Además aporta el eje económico: bajo el matcher laxo, el modelo de pesos abiertos (DeepSeek-R1, MIT) registra la mayor precisión (88.5%) y F1 (78.7%) de la comparación, a ~$0.08 por auditoría (15–69× más barato); su menor recall de una sola pasada (70.8%) se recupera con un auto-ensemble de bajo costo. Estas cifras son una estimación optimista (matcher laxo, corrida única) que no habilita un ranking confiable de proveedores: el Paper 1 difiere el ranking de proveedores —bajo el juez oficial de EVMBench— a trabajo futuro. La taxonomía de tres niveles de apertura y el análisis económico completo están en el Capítulo 6 (Tabla 6.2b).
5.3.6 Validación post-defensa en SmartBugs (143 contratos)¶
Con posterioridad a la defensa, la detección se validó sobre el benchmark público SmartBugs Curated (143 contratos), ampliando la evaluación más allá del corpus interno de 29 vulnerabilidades. El perfil es recall-first, coherente con el propósito de triage pre-auditoría:
Tabla 5.8c. Detección sobre SmartBugs Curated (validación post-defensa, línea v5.x).
| Métrica | Valor |
|---|---|
| Contratos | 143 |
| Recall | 95.8% (137/143) |
| Precisión | 22.2% |
| F1 | 0.360 |
La baja precisión refleja un conjunto grande de falsos positivos —el trade-off consciente de una herramienta de triage—; el filtro de producción los reduce sin perder verdaderos positivos (Trabajos Futuros, Cap. 8, y Paper 1). El resultado se re-validó de forma independiente el 2026-07-09 en un entorno Docker pineado (miesc:5.4.1-solc, qwen2.5-coder:14b): precisión 19.9%, recall 97.9% sobre n=143. La evidencia peritable (comando exacto, digests de imagen, hashes de artefactos y versiones de solc) está en docs/evidence/smartbugs_revalidation_20260709/ y en el apéndice de estadísticas; el detalle metodológico, en el Paper 1.
5.4 Resultados: Normalización y Deduplicación (RQ3)¶
5.4.1 Efectividad de la Deduplicación¶
Las capas evaluadas generaron un total de 385 hallazgos brutos sobre el corpus, que el algoritmo de deduplicación (§4.6.2) redujo a 123 hallazgos únicos.
Tasa de deduplicación: (385 - 123) / 385 × 100 = 68.1%
Tabla 5.9. Análisis de hallazgos duplicados — desglose sobre el contrato de referencia VulnerableBank (47→16 hallazgos, 31 duplicados). Sobre el corpus completo la deduplicación es 385→123 (262 duplicados, §5.4.1); el desglose por tipo no se reconstruyó a ese nivel.
| Tipo de Duplicado | Cantidad | Porcentaje | Ejemplo |
|---|---|---|---|
| Mismo hallazgo, múltiples herramientas | 21 | 67.7% | Reentrancy detectado por Slither, Mythril, GPTScan |
| Mismo hallazgo, misma herramienta, variantes | 7 | 22.6% | Slither reporta reentrancy-eth y reentrancy-no-eth |
| Falso duplicado (hallazgos distintos, misma línea) | 3 | 9.7% | Diferentes issues en función compleja |
| Total duplicados | 31 | 100% |
5.4.2 Validación del Mapeo Taxonómico¶
Se validó manualmente el mapeo de clasificaciones nativas a taxonomías estándar:
Tabla 5.10. Validación manual del mapeo taxonómico sobre una muestra de 35 hallazgos de la corrida original (incluye Mythril, no disponible en el entorno de reproducción ARM64, §5.3.3). El 97.1% es una estimación sobre esa muestra; el procedimiento de muestreo no quedó documentado, por lo que no debe leerse como precisión a escala del corpus.
| Herramienta | Hallazgos Mapeados | Mapeo Correcto | Precisión Mapeo |
|---|---|---|---|
| Slither | 12 | 12 | 100% |
| Mythril | 8 | 8 | 100% |
| GPTScan | 9 | 8 | 88.9% |
| SMTChecker | 6 | 6 | 100% |
| Total | 35 | 34 | 97.1% |
El único error de mapeo en GPTScan correspondió a una clasificación ambigua del modelo de lenguaje que fue corregida manualmente.
Resultado RQ3. La normalización logra una deduplicación del 68% (385→123 sobre el corpus) y, sobre la muestra de la Tabla 5.10, una precisión de mapeo del 97.1%, lo que respalda el enfoque con las salvedades señaladas en esa tabla.
5.5 Resultados: Viabilidad en Producción (RQ4)¶
5.5.1 Tiempos de Ejecución¶
Tabla 5.11. Tiempos de ejecución por capa (promedio de 10 ejecuciones)
| Capa | Herramientas | Tiempo Promedio (s) | Desviación Estándar | Ejecuta en Paralelo |
|---|---|---|---|---|
| 1 | Slither, Solhint, Securify2, Semgrep | 3.2 | 0.4 | Sí |
| 2 | Echidna, Foundry, Medusa, Vertigo | 18.7 | 2.1 | Sí |
| 3 | Mythril, Manticore, Oyente | 52.4 | 8.3 | Sí |
| 4 | Scribble, Halmos | 14.1 | 1.8 | Sí |
| 5 | SMTChecker, Certora | 9.8 | 1.2 | Sí |
| 6 | PropertyGPT, Aderyn, Wake | 21.3 | 3.4 | Sí |
| 7 | GPTScan, SmartLLM, LLMSmartAudit, etc. | 41.6 | 5.7 | Sí |
| Total (secuencial) | 161.1 | |||
| Cota inferior teórica (todas las capas en paralelo) | 52.4 |
Observación: El orquestador ejecuta las herramientas en paralelo dentro de cada capa y las capas en secuencia (§4.6.1), por lo que el tiempo total de diseño es la suma de los tiempos por capa: 161.1 s. El valor de 52.4 s es la cota inferior que se alcanzaría si todas las capas corrieran en paralelo (el tiempo de la capa más lenta) y no corresponde a la implementación evaluada; la ley de Amdahl (1967) acota la ganancia de la paralelización intra-capa al tiempo de la herramienta más lenta de cada capa.
5.5.2 Consumo de Recursos¶
Tabla 5.12. Consumo de recursos durante auditoría completa
| Recurso | Valor Pico | Valor Promedio | Requerimiento Mínimo |
|---|---|---|---|
| Memoria RAM | 6.2 GB | 4.1 GB | 8 GB recomendado |
| CPU | 95% | 65% | Multi-core recomendado |
| Disco (cache) | 312 MB | 280 MB | 1 GB disponible |
| GPU (Ollama) | 4.2 GB VRAM | 3.8 GB | Opcional (CPU fallback) |
5.5.3 Análisis de Costo¶
Tabla 5.13. Comparativa de costo operativo
| Solución | Costo por Auditoría | Costo Mensual (100 auditorías) | Costo Anual |
|---|---|---|---|
| MIESC (local, open-weight) | $0.00 | $0.00 | $0.00 |
| MIESC (open-weight alojado, DeepSeek-R1) | ~$0.08 | ~$8.00 | ~$96.00 |
| GPTScan + GPT-4 API | $0.15 | $15.00 | $180.00 |
| MythX Cloud (Pro) | $0.50 | $50.00 | $600.00 |
| Certora Cloud | ~$100 | ~$10,000 | ~$120,000 |
| Auditoría manual | $5,000-50,000 | N/A | N/A |
Nota: Costos estimados basados en precios públicos de noviembre 2024. El nivel open-weight alojado en un servicio de terceros (pesos MIT accedidos por API, ~$0.08/auditoría) es 15–69× más barato que las APIs frontier; su precisión y F1 bajo el matcher laxo se discuten en §5.3.5 y en la Tabla 6.2b.
Resultado RQ4. Los datos indican que MIESC es viable para uso en producción: una auditoría con las siete capas en secuencia, con paralelismo dentro de cada capa, demanda alrededor de 2.7 minutos (161.1 s, Tabla 5.11); 8 GB de RAM resultan suficientes, y el costo operativo es nulo cuando la ejecución es local. La segunda parte de la pregunta —la calidad del análisis semántico de un LLM local frente a los servicios comerciales— se responde en §5.3.4 y §5.7.4: la configuración local quedó por debajo de la frontier (44% frente a 72%).
5.6 Análisis de Validez¶
Siguiendo las directrices de Wohlin et al. (2012), se analizan a continuación las amenazas a la validez del estudio.
5.6.1 Validez Interna¶
La principal amenaza a la validez interna es el sesgo en la selección de los contratos de prueba, agravado por el hecho de que el corpus y su etiquetado son de diseño propio. Para acotarla se emplearon exclusivamente contratos con vulnerabilidades conocidas y documentadas, siguiendo la metodología de Durieux et al. (2020), aunque esta medida no elimina el riesgo de que el diseño favorezca a las herramientas evaluadas.
5.6.2 Validez Externa¶
El tamaño reducido del corpus limita la generalización de los resultados. Esta amenaza solo se mitiga parcialmente: los contratos cubren las categorías SWC más frecuentes (Tabla 3.2) y las validaciones posteriores sobre EVMBench (§5.3.5) y SmartBugs Curated (§5.3.6) amplían la base empírica, pero la validación con contratos de producción sigue siendo necesaria.
5.6.3 Validez de Constructo¶
Cabe la posibilidad de que las métricas empleadas no capturen la efectividad real de la herramienta. Por ese motivo se recurrió a métricas estándar aceptadas en la literatura (Durieux et al., 2020): cobertura y detección type-aware sobre el corpus propio, y precisión, recall y F1 sobre los benchmarks externos. La propia distinción entre cobertura de línea y detección type-aware (§5.3.1) responde a esta amenaza.
5.6.4 Validez de Conclusión¶
La variabilidad de los tiempos de ejecución podría afectar las conclusiones sobre viabilidad; para controlarla se promediaron diez ejecuciones y se reporta la desviación estándar. Una amenaza mayor es el tamaño muestral reducido (n=29 vulnerabilidades) en las comparaciones de detección. Para acotarla, las tasas de detección type-aware de §5.3.3–5.3.4 se acompañan aquí de intervalos de confianza de Wilson al 95% (Tabla 5.14) y de pruebas de McNemar exactas sobre pares de configuraciones evaluadas sobre las mismas 29 vulnerabilidades (Tabla 5.15). Ambos cálculos se derivan del registro vulnerabilidad por vulnerabilidad de la corrida de revalidación (docs/evidence/corpus_revalidation_20260709/), sin corridas adicionales.
Tabla 5.14. Intervalos de confianza (Wilson, 95%) de la detección type-aware sobre las 29 vulnerabilidades del corpus
| Configuración | Detección | IC 95% |
|---|---|---|
qwen-14b (local, --deep) | 13/29 (44.8%) | [28.4%, 62.5%] |
| MIESC estático + patrón (capas ⅙/7) | 14/29 (48.3%) | [31.4%, 65.6%] |
| Slither (baseline) | 17/29 (58.6%) | [40.7%, 74.5%] |
MIESC --deep (Claude Sonnet) | 21/29 (72.4%) | [54.3%, 85.3%] |
| Ensemble (unión de siete modelos y Slither) | 25/29 (86.2%) | [69.4%, 94.5%] |
Tabla 5.15. Pruebas de McNemar exactas entre pares de configuraciones sobre las mismas 29 vulnerabilidades
| Comparación pareada (McNemar exacto) | Solo A | Solo B | p |
|---|---|---|---|
| A: estático ⅙/7 — B: Slither | 8 | 5 | 0.581 |
A: estático ⅙/7 — B: --deep (Sonnet) | 9 | 2 | 0.065 |
A: Slither — B: --deep (Sonnet) | 5 | 1 | 0.219 |
A: qwen-14b local — B: --deep (Sonnet) | 8 | 0 | 0.008 |
A: --deep (Sonnet) — B: Ensemble | 4 | 0 | 0.125 |
| A: Slither — B: Ensemble | 8 | 0 | 0.008 |
| A: qwen-14b local — B: Ensemble | 12 | 0 | <0.001 |
Nota. "Solo A" y "Solo B" cuentan las vulnerabilidades detectadas por una configuración y no por la otra (pares discordantes); el valor p corresponde a la prueba binomial exacta bilateral sobre esos pares. Con n=29 los intervalos son amplios y se solapan en casi todos los casos. De los siete pares evaluados, solo tres alcanzan significación al 5%: el detector frontier frente a la configuración local (p=0.008), el ensemble frente a Slither (p=0.008) y el ensemble frente a la configuración local (p<0.001); la mejora del detector frontier sobre la configuración estática queda en el límite (p=0.065) y la del ensemble sobre el mejor detector individual no alcanza significación (p=0.125). Las conclusiones de §5.7.2 deben leerse, por lo tanto, como tendencias consistentes sobre un corpus pequeño y no como diferencias establecidas estadísticamente; una muestra mayor forma parte del trabajo futuro (§8.3).
5.7 Discusión¶
5.7.1 Respuesta a RQ1¶
MIESC logró integrar las 25 herramientas propuestas (100% de disponibilidad). Los principales desafíos fueron tres: la compatibilidad de versiones, ya que Python 3.11 exigió parches en bibliotecas heredadas; las dependencias comerciales, resueltas con la migración a Ollama, que eliminó los costos de API; y la obsolescencia, que Docker permitió sortear manteniendo operativas las herramientas legacy. Estos resultados respaldan la decisión de diseño de utilizar el patrón Adapter (Gamma et al., 1994) para encapsular la heterogeneidad.
5.7.2 Respuesta a RQ2¶
La medición controlada contra Slither (§5.3.3) matiza la hipótesis de complementariedad. Combinar herramientas estáticas y de patrón (capas ⅙/7) no mejoró la detección type-aware respecto de la mejor herramienta individual —48% frente al 58% de Slither, con cobertura equivalente (100% frente a 96%) pero unas seis veces más falsos positivos—. La ganancia real provino de agregar razonamiento LLM, que elevó la detección type-aware del 48% al 72% y superó a Slither, y de combinar modelos diversos en ensemble (§5.3.4), que la elevó a 86% (unión de detecciones) a costa de precisión. Con n=29, solo tres de los pares comparados alcanzan significación estadística —detector frontier y ensemble frente a la configuración local, y ensemble frente a Slither— y el resto no (§5.6.4, Tabla 5.15).
El resultado es consistente con la literatura, aunque la precisa. Rameder et al. (2022) sostienen que ninguna herramienta individual es suficiente, y Durieux et al. (2020) muestran que ninguna cubre todas las clases de vulnerabilidad; la medición realizada agrega que la complementariedad efectiva requiere análisis semántico y no solo la acumulación de herramientas estáticas. La contribución del enfoque multicapa reside, por tanto, en integrar una capa de razonamiento LLM sobre el análisis estático, no en la mera combinación de herramientas estáticas. El recorrido que llevó a este resultado —y por qué se publica tal como es— se relata en §8.1.4.
5.7.3 Respuesta a RQ3¶
La tasa de deduplicación del 68% muestra que múltiples herramientas detectan las mismas vulnerabilidades bajo nomenclaturas distintas. Normalizar los hallazgos a SWC/CWE/OWASP reduce, en consecuencia, el ruido de los reportes, facilita la comparación entre auditorías y habilita la trazabilidad hacia estándares reconocidos.
5.7.4 Respuesta a RQ4¶
Los resultados respaldan la viabilidad en producción. El tiempo total, cercano a los tres minutos, resulta del encadenamiento secuencial de las capas y está dominado por la ejecución simbólica; los requerimientos de recursos son moderados (8 GB de RAM), y la ausencia de costo operativo en modo local reduce una barrera habitual de adopción. En cuanto a la calidad del análisis semántico, el LLM local quedó por debajo de los servicios comerciales en el corpus (44% frente a 72% de detección type-aware, §5.3.4) y en EVMBench (59.2% frente a 73.7–82.5% de recall, §5.3.5): la configuración soberana es viable, pero con un costo en capacidad de detección que el Capítulo 6 pondera frente a sus beneficios.
5.8 Limitaciones¶
-
Corpus limitado: 4 contratos con vulnerabilidades conocidas no representan la complejidad de producción.
-
Falsos positivos: La precisión agregada es baja (≈7.5%: 385 hallazgos brutos para 29 vulnerabilidades, 123 tras deduplicar), rasgo propio de una herramienta de triage recall-first; la capa 7 aportó falsos positivos adicionales (2 en el contrato de referencia), lo que sugiere refinar los prompts.
-
Dependencia de Ollama: El rendimiento de la capa IA depende del modelo disponible.
-
Vulnerabilidades de lógica: Algunas categorías (oracle manipulation, flash loans) requieren contexto externo no disponible.
-
Configuración de los resultados titulares: la detección type-aware del 72% se obtuvo con un modelo frontier accedido vía API (
--deep); la configuración completamente local alcanzó 44% (§5.3.3). -
Corridas únicas y muestra pequeña: todos los resultados con LLM corresponden a una sola corrida por modelo, por lo que no se midió la variabilidad entre ejecuciones; con n=29 los intervalos de confianza son amplios y la mayoría de las comparaciones pareadas no alcanza significación (§5.6.4, Tablas 5.14–5.15).
-
Protocolo de emparejamiento: las cifras de EVMBench (§5.3.5) provienen del matcher laxo, una estimación optimista; bajo el juez oficial la misma corrida rinde 27.4%.
-
Corpus y ground truth de diseño propio: el corpus de 29 vulnerabilidades y su etiquetado fueron elaborados por el autor, lo que introduce un riesgo de sesgo de diseño que la selección de vulnerabilidades documentadas mitiga solo parcialmente (§5.6.1).
5.9 Referencias del Capítulo¶
Amdahl, G. M. (1967). Validity of the single processor approach to achieving large scale computing capabilities. AFIPS Spring Joint Computer Conference, 483-485.
Digital Public Goods Alliance. (2023). Digital Public Goods Standard. https://digitalpublicgoods.net/standard/
Durieux, T., Ferreira, J. F., Abreu, R., & Cruz, P. (2020). Empirical review of automated analysis tools on 47,587 Ethereum smart contracts. ICSE 2020, 530-541.
Gamma, E., Helm, R., Johnson, R., & Vlissides, J. (1994). Design patterns. Addison-Wesley.
Ghaleb, A., & Pattabiraman, K. (2020). How effective are smart contract analysis tools? ISSTA 2020, 415-427.
Kitchenham, B., & Charters, S. (2007). Guidelines for performing systematic literature reviews in software engineering. Keele University.
Mueller, B. (2018). Smashing Ethereum smart contracts for fun and real profit. HITB Security Conference.
Paradigm. (2021). Foundry documentation. https://github.com/foundry-rs/foundry
Python. (2022). What's new in Python 3.11. https://docs.python.org/3/whatsnew/3.11.html
Rameder, H., Di Angelo, M., & Salzer, G. (2022). Review of automated vulnerability analysis of smart contracts on Ethereum. Frontiers in Blockchain, 5, 814977.
Runeson, P., Host, M., Rainer, A., & Regnell, B. (2012). Case study research in software engineering. Wiley.
Wohlin, C., Runeson, P., Höst, M., Ohlsson, M. C., Regnell, B., & Wesslén, A. (2012). Experimentation in software engineering. Springer.