Capítulo 8: Conclusiones y Trabajos Futuros¶
MIESC: Reflexiones Finales y Líneas de Investigación¶
8.1 Conclusiones¶
8.1.1 Síntesis del Trabajo Realizado¶
El presente trabajo de tesis ha presentado MIESC (Multi-layer Integration for Ethereum Smart Contract Security), un framework de código abierto que implementa una arquitectura de defensa en profundidad para la auditoría automatizada de contratos inteligentes. El trabajo buscó contribuir al campo de la seguridad de smart contracts abordando las brechas identificadas en el estado del arte; las secciones siguientes evalúan en qué medida lo logró.
8.1.2 Objetivos Alcanzados¶
Tabla 8.1. Evaluación del cumplimiento de los objetivos específicos (redacción del Capítulo 1)
| Objetivo específico | Indicador | Resultado | Estado |
|---|---|---|---|
| OE1 — Integración de herramientas (≥20) | Herramientas operativas | 25/25 disponibles en el entorno de evaluación (Tabla 5.3) | Cumplido |
| OE2 — Normalización de salidas | Mapeo SWC/CWE/OWASP y deduplicación | Precisión de mapeo 97.1% sobre la muestra verificada (Tabla 5.10); deduplicación 68% (385→123) | Cumplido |
| OE3 — Arquitectura Defense-in-Depth (7 capas) | Capas implementadas y evaluadas | 7 capas implementadas; la detección se midió sobre las capas ⅙/7 (Tabla 5.6); la complementariedad entre herramientas estáticas no se confirmó (§5.3.3), sí la aportada por la capa LLM | Cumplido con matices |
| OE4 — Soberanía de datos (backend Ollama) | Análisis sin transmisión externa | Backend local operativo con costo $0/auditoría; el mejor resultado type-aware (72%) requirió un modelo frontier vía API (--deep); el modelo local alcanzó 44% | Cumplido; capacidad local inferior (§6.2.4) |
| OE5 — Interfaz conversacional (MCP) | Servidor MCP operativo | Implementado; el servidor y las herramientas corren localmente, el cliente principal (Claude) es un servicio en la nube (§7.7.1) | Cumplido con la salvedad de §7.7.1 |
| H1/RQ2 — Mejorar la detección type-aware | Superar a la mejor herramienta individual | Estáticas combinadas 48% < Slither 58%; 72% con capa LLM frontier; 86% con ensemble multi-modelo | Parcial (§8.1.4) |
8.1.3 Contribuciones Principales¶
La contribución central es una arquitectura de siete capas que, hasta donde alcanza la revisión del Capítulo 3, constituye la primera implementación documentada de defensa en profundidad aplicada específicamente a la auditoría de smart contracts, y que combina análisis estático, dinámico, simbólico, formal y basado en IA. Esa arquitectura descansa sobre dos piezas de ingeniería: el protocolo ToolAdapter, una interfaz unificada que, siguiendo los principios SOLID y el patrón Adapter, permite integrar herramientas heterogéneas sin modificar el núcleo, y un sistema de normalización triple que mapea automáticamente los hallazgos a SWC, CWE y OWASP, con una precisión del 97.1% sobre la muestra verificada (Tabla 5.10).
Dos contribuciones adicionales responden a la orientación soberana y abierta del trabajo. La migración a un backend local mediante Ollama eliminó la dependencia de APIs comerciales en cumplimiento de los requisitos DPGA, y el rescate de herramientas legacy —con parches documentados para Manticore (Python 3.11) y Oyente (imagen Docker)— preservó capacidades de análisis que de otro modo se habrían perdido. El servidor MCP convierte a MIESC, según la misma revisión, en la primera herramienta de auditoría de smart contracts con soporte nativo para Model Context Protocol, lo que habilita su integración con Claude y otros asistentes de IA.
La séptima contribución es de otro orden: la tesis de que el control sobre la herramienta —pesos abiertos, ejecución auditable— es un requisito de primer orden del análisis de seguridad y no una preferencia, fundamentada en el plano doctrinal, científico, epistemológico y filosófico (Cap. 6, §6.6.3). Su correlato empírico es que, en la comparación de EVMBench y bajo el matcher laxo, un modelo de pesos abiertos registra la mayor precisión (88.5%) y F1 (78.7%) de la comparación a unos USD 0.08 por auditoría (15–69 veces menos). Se trata de una estimación optimista, cuyo ranking de proveedores bajo el juez oficial queda diferido a trabajo futuro, pero suficiente para indicar que la elección soberana ya no exige sacrificar capacidad.
8.1.4 Validación de Hipótesis¶
Las tres hipótesis se evalúan con la redacción con que fueron formuladas en la sección 1.5.
H1 (un framework que integre múltiples herramientas mediante el patrón Adapter puede alcanzar una tasa de detección superior a cualquier herramienta individual): se sostiene de forma parcial y matizada. Combinar herramientas estáticas y de patrón no superó a Slither por sí sola (48% frente a 58% de detección type-aware, con cobertura equivalente —100% frente a 96%— y unas seis veces más falsos positivos). La superación de la mejor herramienta individual se alcanzó únicamente al incorporar razonamiento semántico: 72% con una capa LLM frontier (--deep) y 86% con un ensemble multi-modelo (§5.3.3–5.3.4). La complementariedad efectiva exige, por lo tanto, análisis semántico y no la mera acumulación de herramientas estáticas. Debe notarse, además, que el 72% es el valor de MIESC con un único modelo frontier como detector de la capa 7 (§5.3.4, Tabla 5.8), de modo que la ganancia adicional atribuible a la arquitectura por sobre ese detector único solo se observa en la configuración de ensemble (86%, unión de siete modelos y Slither; 83% sin Slither), diferencia que con n=29 no alcanza significación estadística (§5.6.4). La hipótesis se sostiene como tendencia consistente, no como resultado estadísticamente establecido.
El autor no esperaba este resultado, y conviene decir cómo se llegó a él. La versión defendida de esta tesis sostenía que MIESC mejoraba el recall en un 40,8% respecto de la mejor herramienta individual. Al reconstruir la evaluación para hacerla reproducible, en julio de 2026, se comprobó que esa cifra descansaba sobre bases que no resistían la verificación: uno de los contratos del corpus original no existía tal como estaba descrito, y la línea base de Slither no se había medido en las mismas condiciones que MIESC. La alternativa cómoda era ajustar la configuración hasta recuperar un número parecido. La decisión fue la contraria: rehacer la medición completa —ground truth anotado en el código fuente, Slither ejecutado de forma aislada sobre el mismo corpus, idéntico criterio de correlación— y publicar lo que diera, aunque invalidara el claim central del capítulo. Dio 48% frente a 58%.
Lo que ese resultado enseñó es que la defensa en profundidad, trasladada a herramientas de análisis, no es aditiva: apilar detectores de la misma naturaleza suma ruido antes que cobertura, y la complementariedad es algo que se mide, no que se asume. La ganancia real apareció recién al cambiar la naturaleza del componente —razonamiento semántico— y al combinar razonadores distintos. Publicar el resultado con sus intervalos de confianza y sus límites (§5.6.4) no es una concesión: es la misma exigencia que el Capítulo 6 le hace a las herramientas que MIESC integra. Una evidencia de seguridad que no puede auditarse no merece defenderse.
H2 (la normalización a taxonomías estándar permite reducir significativamente los duplicados sin pérdida de información): se sostiene en su primera parte; la segunda no fue demostrada. La deduplicación alcanzó el 68% (385→123) con una precisión de mapeo del 97.1% sobre la muestra verificada (Tabla 5.10). La ausencia de pérdida de información no se midió como tal: la Tabla 5.9 registra tres "falsos duplicados" (hallazgos distintos fusionados), lo que indica una pérdida acotada pero no nula.
H3 (la ejecución de LLMs locales mediante Ollama proporciona capacidades de análisis semántico comparables a servicios comerciales, con costo operativo cercano a cero): no se sostiene tal como fue formulada. En el corpus, el modelo local (qwen2.5-coder:14b) alcanzó 44% de detección type-aware frente al 72% del modelo frontier; en EVMBench, el modelo local de 32B alcanzó 59.2% de recall frente a 73.7–82.5% de los frontier, siempre bajo el matcher laxo. El costo cercano a cero sí se verifica. La formulación que la evidencia sí sostiene es la del Capítulo 6: los modelos de pesos abiertos son viables —el open-weight alojado registra la mayor precisión y F1 de la comparación bajo el matcher laxo— y la ejecución 100% local tiene un costo de recall medido, no asumido. Esta reformulación se adopta como conclusión (§8.5); la comparación de proveedores bajo el juez oficial queda como trabajo futuro (§8.3.1).
8.2 Limitaciones del Trabajo¶
8.2.1 Limitaciones Técnicas¶
En el plano técnico, el análisis de contratos muy grandes (más de 1000 líneas) puede demandar más de cinco minutos, sobre todo en la capa de ejecución simbólica (Mythril, Manticore); la calidad del análisis de la capa 7 depende del modelo disponible, y los modelos más pequeños tienden a producir más falsos positivos; las vulnerabilidades de lógica de negocio —flash loans, manipulación de oráculos, MEV— requieren un contexto externo del que el análisis estático no dispone; y MIESC está optimizado para Ethereum y las cadenas compatibles con la EVM, de modo que otras blockchains (Solana, Cosmos) requerirían adaptadores específicos.
8.2.2 Limitaciones Metodológicas¶
En el plano metodológico, la validación principal se realizó sobre un corpus de diseño propio de 4 contratos (614 líneas) y 29 vulnerabilidades documentadas, que según Durieux et al. (2020) puede sobreestimar la efectividad y que, con n=29, deja la mayoría de las comparaciones sin significación estadística (§5.6.4); los resultados con LLM corresponden a corridas únicas; no se realizó una validación con contratos desplegados en mainnet con vulnerabilidades desconocidas, aunque las validaciones posteriores sobre EVMBench y SmartBugs (§5.3.5–5.3.6) y los exploits reales del Paper 1 (§8.3.1) acotan esa carencia; y algunas salidas de la capa 7 (ThreatModel, BestPractices) producen recomendaciones cualitativas difíciles de cuantificar. Las limitaciones detalladas de la evaluación se enumeran en §5.8.
8.3 Trabajos Futuros¶
Varias de las líneas trazadas en esta sección ya fueron iniciadas y publicadas con posterioridad a la defensa, en las publicaciones derivadas de esta tesis. Se resumen primero esos avances y luego las líneas que permanecen abiertas.
8.3.1 Publicaciones derivadas y líneas ya iniciadas (post-defensa)¶
El trabajo de esta tesis dio lugar a dos artículos presentados en el IV Simposio Internacional de Blockchain y Ciberseguridad (RIBCi–CYTED 2026, IEEE, revisión doble ciego):
- Paper 1 — Detección (Boiero et al., 2026a): consolida la evaluación de detección y aporta evidencia que no formaba parte del corpus defendido:
- Exploits reales: 9/11 detectados (81.8% de recall; IC Wilson 95% [52%, 95%]) sobre USD 1.59B en pérdidas evaluadas —un primer paso de la Línea 1.
- Ablación sin LLM: estático 82.5% → +detectores propios 93.0% → +inteligencia 97.9% sobre los 143 contratos de SmartBugs (cada etapa suma contratos sin perder ninguno; significancia por prueba de McNemar) —cuantifica el aporte de la Línea 2.
- EVMBench bajo triple protocolo: una misma corrida medida bajo tres protocolos —matcher laxo (92.5% unión / 88.3% una corrida), control nulo, y juez oficial de EVMBench con GPT-5 (27.4%)—, mostrando que todo score de EVMBench debe reportar el protocolo y el juez utilizados.
- Filtro de falsos positivos: reduce 207 de 1.263 FP (16%) sin perder verdaderos positivos, elevando la precisión a nivel de finding de 13.3% a 15.5%.
- Paper 2 — Remediación (Boiero et al., 2026b): aplica y verifica reparaciones automáticas (123/143 contratos parcheados, 123/123 compilan, 88/123 eliminan el hallazgo HIGH/CRITICAL, 121/123 sin regresión) —realización de la Línea 5 (integración con el ecosistema de desarrollo). No reclama equivalencia semántica ni prueba formal corpus-wide: ambas siguen abiertas (Línea 4).
Las líneas que permanecen abiertas se detallan a continuación. En particular, el ranking de proveedores de LLM bajo el juez oficial de EVMBench (no concluido con el matcher laxo; ver Cap. 6) y un loop de detección agéntico para vulnerabilidades de lógica de negocio son las dos prioridades que el Paper 1 señala como trabajo futuro inmediato.
8.3.2 Línea 1: Extensión de Cobertura de Vulnerabilidades¶
La primera línea busca ampliar la detección hacia las vulnerabilidades emergentes del ecosistema DeFi. Su urgencia surge de la evidencia: Qin et al. (2021) documentan pérdidas superiores a USD 1B por vulnerabilidades de flash loans que las herramientas tradicionales no detectan, y en el propio corpus de esta tesis las vulnerabilidades de lógica DeFi fueron las únicas que ningún modelo detectó (§5.3.4). La tabla siguiente desagrega las tareas propuestas.
| Tarea | Descripción | Complejidad | Impacto |
|---|---|---|---|
| TF-1.1 | Detección de vulnerabilidades de flash loans | Alta | Alto |
| TF-1.2 | Análisis de dependencias de oráculos | Media | Alto |
| TF-1.3 | Detección de MEV (Maximal Extractable Value) | Alta | Medio |
| TF-1.4 | Análisis de composabilidad DeFi | Alta | Alto |
| TF-1.5 | Detección de rug pulls en tokens | Media | Alto |
El enfoque técnico previsto combina tres frentes: el análisis de transacciones históricas para identificar patrones de explotación, un adaptador para Forta Network que aporte detección en tiempo real, y la simulación de ataques de flash loan con Foundry.
8.3.3 Línea 2: Mejora de Modelos de IA¶
La segunda línea apunta a incrementar la precisión de la capa 7 mediante el ajuste fino de modelos especializados. La motivación es directa: la Tabla 5.8 muestra que el modelo empleado determina en gran medida la detección, y la brecha entre la configuración local y la frontier (44% frente a 72%) es la que un modelo abierto afinado para Solidity debería cerrar. Las tareas propuestas son las siguientes.
| Tarea | Descripción | Complejidad | Impacto |
|---|---|---|---|
| TF-2.1 | Fine-tuning de CodeLlama para Solidity | Alta | Muy Alto |
| TF-2.2 | Dataset de vulnerabilidades anotadas | Media | Alto |
| TF-2.3 | Benchmark de modelos LLM para auditoría (parcialmente logrado: EVMBench, 40 auditorías, frontier vs open-weight vs local; resta la postulación al leaderboard oficial) | Media | Alto |
| TF-2.4 | Reducción de falsos positivos con RAG | Media | Alto |
| TF-2.5 | Explicabilidad de decisiones de IA | Alta | Medio |
El enfoque técnico previsto es un ajuste fino con LoRA de un modelo abierto de código (por ejemplo, CodeLlama o Qwen2.5-Coder) sobre un conjunto de datos de tuplas (código vulnerable, vulnerabilidad, explicación, corrección) construido a partir del SWC Registry, Immunefi y Code4rena.
8.3.4 Línea 3: Soporte Multi-Chain¶
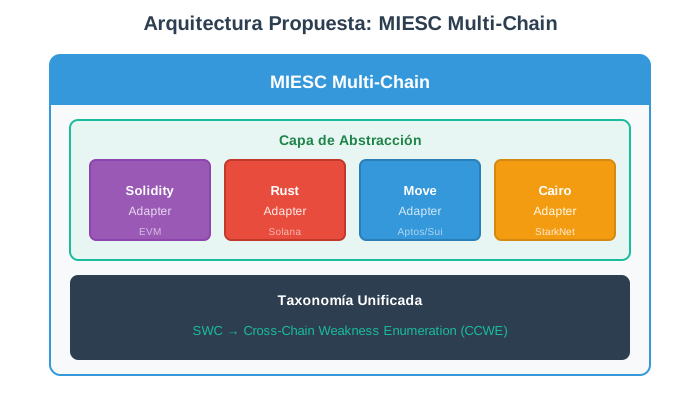
La tercera línea propone extender MIESC a otras blockchains con smart contracts. El ecosistema multi-chain representa más del 40% del valor bloqueado en 2024 (DeFiLlama, 2024) y sus vulnerabilidades carecen de herramientas automatizadas maduras. Las tareas se resumen en la tabla siguiente, y la Figura 8.1 esboza la arquitectura propuesta.
| Tarea | Descripción | Blockchain | Complejidad |
|---|---|---|---|
| TF-3.1 | Adaptadores para Solana (Rust/Anchor) | Solana | Alta |
| TF-3.2 | Adaptadores para Move (Aptos/Sui) | Aptos/Sui | Alta |
| TF-3.3 | Soporte para CosmWasm | Cosmos | Media |
| TF-3.4 | Análisis de contratos Cairo (StarkNet) | StarkNet | Alta |
| TF-3.5 | Mapeo de vulnerabilidades cross-chain | Todas | Media |
Figura 8.1. Arquitectura Multi-Chain propuesta para MIESC
8.3.5 Línea 4: Verificación Formal Avanzada¶
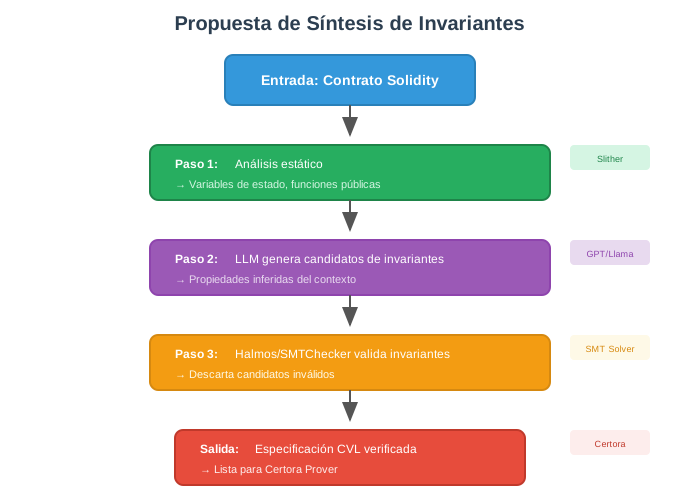
La cuarta línea busca profundizar la verificación formal mediante especificaciones generadas automáticamente. La verificación formal permite demostrar propiedades sobre el estado del contrato de manera exhaustiva dentro del alcance de la especificación (Certora, 2024), pero requiere especificaciones manuales costosas, y esa dependencia fue precisamente lo que dejó a las capas 4 y 5 fuera de la medición de detección (§5.3.2). Las tareas propuestas y la propuesta de síntesis de invariantes (Figura 8.2) apuntan a reducir ese costo.
| Tarea | Descripción | Complejidad | Impacto |
|---|---|---|---|
| TF-4.1 | Generación automática de especificaciones CVL | Alta | Muy Alto |
| TF-4.2 | Integración con Certora Gambit | Media | Alto |
| TF-4.3 | Síntesis de invariantes con IA | Alta | Muy Alto |
| TF-4.4 | Verificación de upgradeability patterns | Media | Alto |
| TF-4.5 | Pruebas de equivalencia pre/post upgrade | Alta | Alto |
Figura 8.2. Propuesta de síntesis de invariantes con IA
8.3.6 Línea 5: Integración con Ecosistema de Desarrollo¶
La quinta línea integra MIESC en el ciclo de vida de desarrollo de smart contracts, y es la más avanzada: tres de sus cinco tareas se implementaron en la versión 4.1.0, como registra la tabla siguiente.
| Tarea | Descripción | Complejidad | Estado |
|---|---|---|---|
| TF-5.1 | Plugin para VS Code / Remix IDE | Media | Pendiente |
| TF-5.2 | GitHub Action para CI/CD | Media | Implementado |
| TF-5.3 | WebSocket Streaming en tiempo real | Media | Implementado |
| TF-5.4 | Dashboard de métricas de seguridad | Media | Implementado (HTML estático) |
| TF-5.5 | Notificaciones de vulnerabilidades en dependencias | Baja | Pendiente |
TF-5.2 GitHub Action¶
La GitHub Action de MIESC (miesc-security-audit.yml) permite integración completa con CI/CD:
# .github/workflows/miesc-security-audit.yml
name: MIESC Security Audit
on:
  push:
    paths: ['**.sol', 'contracts/**']
  pull_request:
    paths: ['**.sol', 'contracts/**']
  workflow_dispatch:
    inputs:
      severity_threshold:
        description: 'Minimum severity to fail (critical, high, medium, low)'
        default: 'high'

jobs:
  security-audit:
    runs-on: ubuntu-latest
    permissions:
      contents: read
      security-events: write
      pull-requests: write
    steps:
      - uses: actions/checkout@v6
      - name: Run MIESC Security Audit
        # Genera SARIF para GitHub Security y comenta en PRs
La acción detecta automáticamente los cambios en archivos .sol, genera reportes SARIF integrados con GitHub Security, comenta en los pull requests con un resumen de los hallazgos, permite configurar un umbral de severidad para bloquear la integración y admite la ejecución manual mediante workflow_dispatch.
TF-5.3 WebSocket Streaming¶
El servidor WebSocket (src/mcp/websocket_server.py) proporciona streaming en tiempo real:
# Conexión: ws://localhost:8765
# Eventos disponibles:
# - audit_started, audit_completed, audit_failed
# - layer_started, layer_completed, layer_failed
# - finding_discovered, findings_batch
# - progress_update, heartbeat

# Ejemplo de uso:
async with websockets.connect("ws://localhost:8765") as ws:
    await ws.send(json.dumps({
        "command": "start_audit",
        "contract_path": "contracts/Token.sol",
        "layers": [1, 2, 3, 7]
    }))
    async for message in ws:
        event = json.loads(message)
        print(f"[{event['event']}] {event['data']}")
El servidor informa el progreso capa por capa en tiempo real, notifica los hallazgos a medida que se descubren, admite múltiples sesiones de auditoría concurrentes, mantiene un latido de conectividad y permite suscribirse a sesiones específicas.
8.3.7 Línea 6: Auditoría Continua en Producción¶
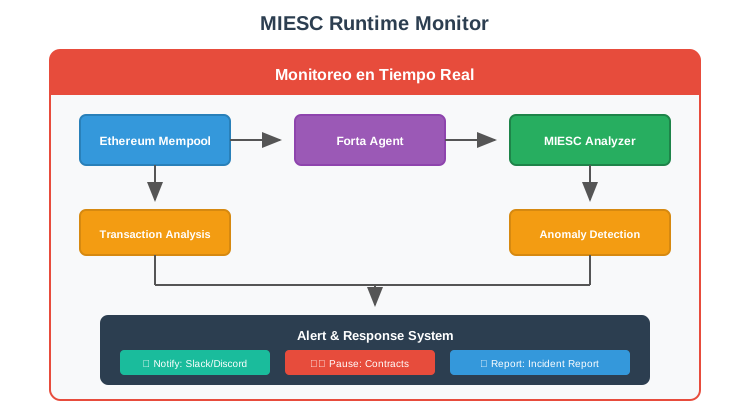
La sexta línea extiende MIESC al monitoreo posterior al despliegue, fuera del alcance de esta tesis (§1.7.2). Las tareas propuestas se resumen en la tabla siguiente y la Figura 8.3 esboza la arquitectura prevista.
| Tarea | Descripción | Complejidad | Impacto |
|---|---|---|---|
| TF-6.1 | Integración con Forta para alertas | Media | Muy Alto |
| TF-6.2 | Análisis de transacciones en tiempo real | Alta | Alto |
| TF-6.3 | Detección de comportamiento anómalo | Alta | Alto |
| TF-6.4 | Sistema de respuesta automática | Alta | Muy Alto |
| TF-6.5 | Dashboard de monitoreo de contratos | Media | Medio |
Figura 8.3. Arquitectura de Auditoría Continua en Producción
8.4 Impacto Esperado¶
8.4.1 Impacto Académico¶
El impacto académico ya se materializó en dos publicaciones derivadas directamente de esta tesis, presentadas en RIBCi–CYTED 2026 (IEEE, revisión doble ciego): el Paper 1, sobre detección, y el Paper 2, sobre remediación (Boiero et al., 2026a, 2026b). Como líneas futuras de difusión se prevén un artículo de revista con la evaluación empírica extendida (por ejemplo, TSE o TOSEM) y presentaciones en talleres de seguridad DeFi. En términos de conocimiento, el trabajo aporta una validación empírica —matizada— de la complementariedad de técnicas, en la que la ganancia proviene del razonamiento semántico y no de acumular herramientas estáticas; un framework reproducible para la investigación; y un conjunto de vulnerabilidades normalizadas.
8.4.2 Impacto Industrial¶
En el plano industrial, la adopción esperada abarca a los desarrolladores independientes, que acceden a una auditoría gratuita; a las startups, para las que una primera revisión de seguridad deja de tener un costo prohibitivo, aunque esa reducción no se cuantificó en esta tesis; y a las empresas, que pueden integrar MIESC en sus pipelines existentes. La detección temprana apunta, además, a prevenir exploits posteriores al despliegue, con una magnitud de pérdidas evitables que tampoco se cuantificó.
8.4.3 Impacto Social¶
El impacto social se vincula con la ampliación del acceso a la seguridad: MIESC es una herramienta gratuita y de código abierto, sin barreras de claves de API ni costos, documentada en español e inglés. Contribuye, asimismo, al ecosistema de Bienes Públicos Digitales mediante el cumplimiento de los estándares DPGA, la licencia AGPL-3.0 (copyleft, aprobada por la OSI) y su portabilidad mediante imágenes Docker multi-arquitectura.
8.5 Reflexiones Finales¶
El desarrollo de MIESC buscó contribuir a ampliar el acceso a la seguridad en smart contracts, en un ecosistema donde las pérdidas por vulnerabilidades superan los miles de millones de dólares anuales y donde, por lo tanto, la disponibilidad de herramientas de auditoría accesibles y efectivas no es un asunto menor.
El resultado más instructivo de la evaluación fue, sin embargo, el que matizó la hipótesis de partida: la mera acumulación de herramientas estáticas no superó a la mejor de ellas, y la ganancia medida provino de incorporar razonamiento semántico con LLM y de combinar razonadores diversos (§5.3.3–5.3.4), con la cautela estadística que impone un corpus de 29 vulnerabilidades (§5.6.4). Esa lección sugiere que, más allá del dominio de los smart contracts, los enfoques multi-técnica merecen evaluarse por la complementariedad real de sus componentes y no por su número. En la misma línea, la evidencia sobre modelos de pesos abiertos (Cap. 6, §6.6.3) indica que el control sobre la herramienta ya no exige renunciar a una capacidad competitiva, aunque la ejecución completamente local conserve un costo de detección medido.
La integración con el Model Context Protocol, por su parte, anticipa un escenario en el que los asistentes de IA acceden directamente a herramientas especializadas de seguridad y amplían tanto las capacidades humanas como las automatizadas; en ese sentido, MIESC se propone no solo como una herramienta de auditoría, sino como una plataforma capaz de evolucionar con el desarrollo asistido por IA. Las líneas de trabajo futuro —algunas ya iniciadas en las publicaciones derivadas (§8.3.1)— y la naturaleza abierta del código invitan a la comunidad a extender esas capacidades.
"La seguridad no es un producto, es un proceso" (Schneier, 2000; traducción propia).
Cierro este trabajo con una convicción que no tenía al empezarlo. Llegué a los smart contracts desde la infraestructura —firma digital, sellado de tiempo, sistemas en los que se confía en el protocolo y no en el intermediario— y a su seguridad desde la necesidad: los proyectos blockchain llevados adelante en el laboratorio blockchain de la universidad o en Xcapit no podían desplegarse sin una auditoría que estuviera a su alcance. MIESC fue mi respuesta de ingeniero a ese problema; la Maestría me obligó a convertirla en una pregunta de investigación y a aceptar la respuesta que dieron los datos, aunque no fuera la que esperaba. Lo que me llevo es menos una herramienta que un criterio: en ciberdefensa, una capacidad que no se controla —un modelo que no puede inspeccionarse, una evidencia que no puede reproducirse— no es una capacidad sino una dependencia. Por eso MIESC es software libre, por eso su evidencia está publicada junto con el código, y por eso espero que quien tome el repositorio lo haga con la misma libertad para mejorarlo que para contradecirlo. Como docente, no se me ocurre un mejor destino para un trabajo de tesis.
8.6 Referencias del Capítulo¶
Boiero, F., Mussetta, S. N., & Cena, N. G. (2026a). MIESC: A multi-layer framework for automated smart contract security evaluation. En Livros de Atas — IV Simposio Internacional de Blockchain y Ciberseguridad (RIBCi–CYTED 2026).
Boiero, F., Mussetta, S. N., & Cena, N. G. (2026b). From findings to verifiable remediation artifacts: A smart contract security pipeline. En Livros de Atas — IV Simposio Internacional de Blockchain y Ciberseguridad (RIBCi–CYTED 2026).
DeFiLlama. (2024). DeFi TVL by Chain. https://defillama.com/chains
Durieux, T., Ferreira, J. F., Abreu, R., & Cruz, P. (2020). Empirical review of automated analysis tools on 47,587 Ethereum smart contracts. ICSE 2020, 530-541.
Qin, K., Zhou, L., Livshits, B., & Gervais, A. (2021). Attacking the DeFi ecosystem with flash loans. FC 2021, 3-32.
Schneier, B. (2000). Secrets and lies: Digital security in a networked world. Wiley.